De lancering van GLM-5.3 door Cloudflare verliep niet zoals gepland, maar het model was niet de oorzaak
GLM-5.3 is een voordelig, krachtig coderingsmodel van Z.ai. De eerste weken dat het model op Cloudflare’s Workers AI draaide, werden gekenmerkt door een lek dat het gevolg was van een fout bij de implementatie en het testen. Hieronder lees je wat er is gebeurd en wat je kunt doen.
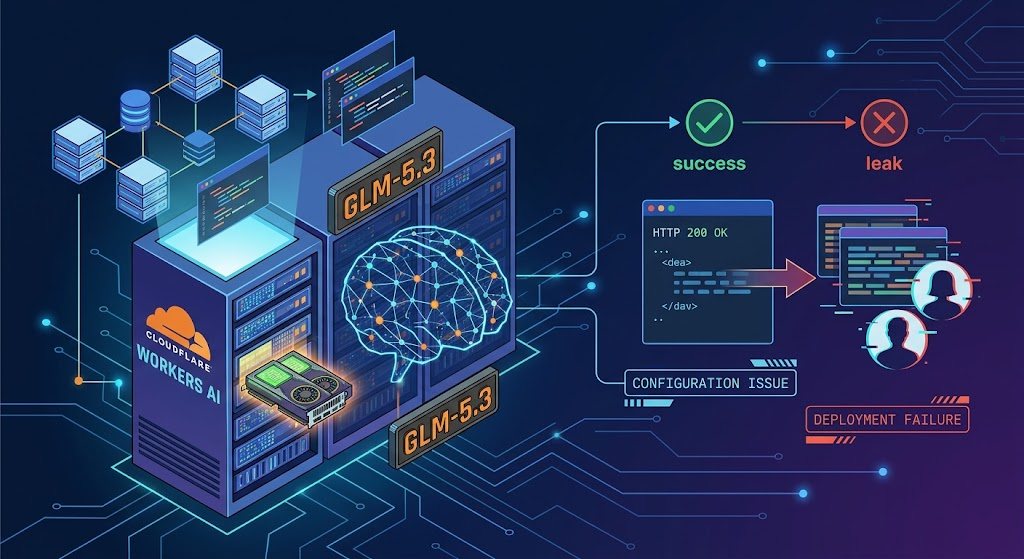
Elke ontwikkelaar kent dat lichte onbehaaglijke gevoel bij een groen vinkje dat je niet helemaal kunt vertrouwen. Ongeveer twee weken lang verborg een succescode een probleem: 155 antwoorden op extra lange prompts bevatten stukjes uit de sessies van andere klanten. Dit verhaal gaat niet over een gebrekkig model, maar over de manier waarop het werd gelanceerd en getest.
GLM-5.3 is het tekstgeneratiemodel van Z.ai dat is ontwikkeld voor agentische programmeerworkflows, en Cloudflare biedt het aan via Workers AI.
Volgens het incidentrapport van Cloudflare van 26 oktober duurde het lek van 27 augustus tot 9 september 2026. Onze conclusie: de oorzaak was niet het model of een aanval, maar een configuratiekeuze in combinatie met een bug in de inferentie-engine. De modelgewichten speelden geen rol.
Wat is GLM-5.3 nu precies?
Z.ai stond bekend als Zhipu AI totdat het in juli 2025 internationaal een rebranding onderging; het bedrijf is voortgekomen uit een onderzoeksgroep aan de Tsinghua-universiteit. De GLM-familie ging in december 2021 van start als een tweetalig Chinees-Engels modelproject. GLM-5.3 werd op 14 augustus 2026 gelanceerd en volgens de modelkaart van Z.ai is het gebaseerd op het basismodel achter GLM-5.2, waarbij elke verbetering voortkomt uit post-training.
In feite gaat het om een ‘mixture-of-experts’-model, wat betekent dat slechts een deel van de parameters – ongeveer 40 miljard – bij elk token wordt gebruikt. De gewichten zijn op 31 augustus 2026 op Hugging Face geplaatst onder een aangepaste Z.ai-licentie in plaats van de MIT-licentie.
Op Workers AI draait Cloudflare het model op zijn eigen GPU’s, zodat ontwikkelaars het model bij naam kunnen aanroepen in plaats van zelf de hardware te moeten beheren.
Wat is er op 9 september eigenlijk misgegaan?
De problemen begonnen met een discrepantie die al vóór de lancering bekend was. Het model werd gelanceerd met een contextvenster van 1.048.576 tokens, maar de cache op de prefill-GPU’s bood slechts ruimte voor 681.280. Het team was hiervan op de hoogte en achtte dit onschadelijk, omdat de tests met lange contexten succesvolle resultaten opleverden.
Vervolgens zorgde de fout in de engine ervoor dat die opening uitmondde in een beveiligingslek. In de ‘disaggregated mode’ van SGLang werden verzoeken die de maximale lengte overschreden gemarkeerd als afgewezen, vervangen door een plaatshouder van één token en doorgestuurd, waarna de decoder verouderde cachepagina’s van eerdere verzoeken las. Clients kregen een HTTP 200-status in plaats van een foutmelding. Een andere gebruiker had de fout al op 6 juli 2026 openbaar gemeld, dus de waarschuwing bestond al lang voordat het lek werd ontdekt. Daarom is een groene statuscode geen bewijs van een correcte respons.
Zodra een onderzoeker het lek had gesignaleerd, duurde het slechts één dag voordat er werd gereageerd. Beveiligingsonderzoeker Gadi Evron van Knostic meldde het op 8 september 2026 via HackerOne. De verificatie begon de volgende dag om 08:00 UTC en om 13:22 werd een incident gemeld nadat het lek met twee accounts was gereproduceerd. Het model werd om 14:00 op privé gezet en kwam om 19:40 UTC weer online. De oplossing volgde snel nadat iemand het probleem had gemeld, maar het lek zelf bleef ongeveer twee weken onopgemerkt.
Hoe lang het model buiten gebruik was, hangt af van wie het bijhoudt. Volgens sommige schattingen duurde de offlineperiode ongeveer 20 uur, maar die tijd wordt gerekend vanaf het moment van de melding, terwijl Cloudflare zelf de duur van de storing meet. De oplossing werd getest aan de hand van de eigen reproductie van de onderzoeker en de canary-markertests voordat het model die avond weer beschikbaar kwam, en het SGLang-project werd nog dezelfde dag op de hoogte gebracht.
In cijfers
- 155: reacties waarbij bevestigd is dat ze getroffen zijn, allemaal op prompts van meer dan 681.280 tokens
- 1.048.576: tokens in het GLM-5.3-contextvenster
- 128K: tokens met maximale output
- 2,04 miljoen: het aantal tokens dat de prefill-pool momenteel bevat
- 14:00 tot 19:40 UTC: de tijd dat het model op 9 september 2026 buiten gebruik was
- 1: dit model is hierdoor beïnvloed, aangezien andere implementaties over grotere cachepools beschikken
Waarom komt dit nu allemaal naar boven?
Het volledige verhaal kwam pas laat naar buiten. Het rapport verscheen ongeveer zeven weken na de oplossing van het probleem. Dat gebeurde nadat de hype rond de lancering van het model was weggeëbd en er een veiligheidsbeoordeling was uitgevoerd door CAISI, een onderdeel van de Amerikaanse norminstantie NIST. Er volgt nog meer, want het rapport van de onderzoeker zelf over de ontdekking en validatie wordt later verwacht.
CAISI concludeerde dat de GLM-5.3 het meest cyberbekwame open-weight-model is dat tot nu toe is uitgebracht, hoewel zijn cybervaardigheden aanzienlijk achterblijven bij de huidige toonaangevende modellen uit de VS. De schatting is dat er een achterstand is van ongeveer vier maanden, en GLM-5.3 werd hoger beoordeeld dan Kimi K3. Die beoordeling is een van de redenen waarom het bericht op dat moment verscheen.
Het debat verliep langs de bekende scheidslijnen. Greg Brockman van OpenAI waarschuwde dat het ‘open-weight’-model de dreigingssituatie waarschijnlijk zal versnellen, terwijl Jake Williams, voormalig analist bij het Ministerie van Defensie, aanvoerde dat aanvallers al over vergelijkbare tools beschikken. Beide kampen lijken wat oververhit, aangezien het oordeel van CAISI zelf ergens tussenin ligt. Voor u betekent dit dat u een model moet kiezen op basis van de prestaties en de manier waarop het wordt ingezet, en niet op basis van de meest opvallende krantenkop over beveiliging.
Is het de moeite waard, en is het goedkoop?
De meest indrukwekkende cijfers zijn die van Z.ai zelf. Op de modelkaart wordt een verbetering van 50% ten opzichte van de eigen Code Bench vermeld, maar het lab zelf meldt dat Fable 5 nog steeds aan kop gaat. Onafhankelijke beoordelingen vallen bescheidener uit, dus vertrouw liever op externe tests dan op de lanceringspagina.
Ten opzichte van Kimi K3, de naaste concurrent, is het bijna een gelijkspel. Kimi K3 wint 5 van de 9 gemeenschappelijke benchmarks en verwerkt ook afbeeldingen, wat GLM-5.3 niet doet. Het contextvenster is identiek, en Kimi K3 heeft veel meer parameters.
Op het gebied van prijs neemt GLM-5.3 de leiding. De catalogusprijs van Z.ai bedraagt $1,40 per miljoen invoertokens, en het model komt per token ongeveer 3,0 keer goedkoper uit dan Kimi K3. De catalogusprijzen doen echter geen recht aan langdurige agentruns, aangezien een taak waarbij maximale inspanning wordt geleverd meer kost dan een taak waarbij weinig inspanning nodig is.
Er is hier één belangrijk punt van aandacht: uit de gegevens blijkt geen prijs van Workers AI voor GLM-5.3, en op de vergelijkingspagina wordt Workers AI helemaal niet vermeld. Het kostenvoordeel is waarschijnlijk reëel bij de prijzen van Z.ai, maar voor Workers AI is dit niet bewezen.
Wat het betekent als je met Workers AI aan de slag gaat
Onze conclusie is dat GLM-5.3 geschikt is voor teams die codeeragenten of pijplijnen voor codereview ontwikkelen en op zoek zijn naar een krachtig open model zonder dat ze zich met GPU’s hoeven bezig te houden. Zelfhosting is het alternatief, en daarvoor zijn minimaal 8 GPU’s van de H200-klasse of beter nodig; dit is dus alleen zinvol als je controle wilt hebben over je eigen hardware. Het is minder geschikt voor gevoelige gegevens bij extreem lange contextlengtes, voor teams die beeldverwerking nodig hebben, of voor kopers met inkoopbeperkingen voor leveranciers uit de Volksrepubliek China.
Een paar handelingen kunnen hierbij helpen. Stuur een `x-session-affinity`-header mee voor agentsessies, beperk de lengte van de prompt in je eigen gateway en controleer de inhoud van de uitvoer in plaats van alleen de statuscodes. In het incidentrapport kun je nagaan of jouw account tot de getroffen verzoeken behoorde.
Serverloze capaciteit wordt gedeeld en er is geen strikte garantie op verwerking. Dat is van belang omdat de asynchrone API de aanbevolen methode is voor duurzame workflows; teams met langlopende taken zouden daar dus mee moeten beginnen. Raadpleeg voordat u hiermee aan de slag gaat de huidige prijspagina van Workers AI en vergelijk het model met uw eigen taken.
Waar dit naartoe leidt
Wij zijn van mening dat GLM-5.3 een betrouwbaar, kostenefficiënt coderingsmodel is dat een stap achterblijft bij de ‘closed frontier’-modellen. Het aantal betrokken reacties wijst op beperkte schade, wat niet wil zeggen dat schade volledig is uitgesloten.
Het basisscenario is een gestage groei onder kostenbewuste codeerders, zolang de grotere cachepool en de SGLang v0.5.22-fix standhouden. Het risico is dat verdere details het vertrouwen ondermijnen en dat voorzichtige ondernemingen overstappen op gesloten of andere gehoste modellen. Let op eventuele herzieningen van het aantal getroffen gevallen en op wijzigingen in de manier waarop het model wordt getest.
Wat de mogelijkheden betreft, zou er nog een snelle release van Z.ai kunnen volgen, en de vertraging van vier maanden bij CAISI is slechts een momentopname. De aangepaste licentie en de gefaseerde release zouden bepalend kunnen zijn voor wie het systeem gaat gebruiken. Wat u vervolgens in de gaten moet houden: een gepubliceerde prijs voor Workers AI, het rapport van de onderzoeker en nieuwe CAISI-resultaten.
Bronnen 12unite.ai, BigGo Finance, Cloudflare en nog 9 bronnen
- unite.ai (Oct 26, 2026). Cloudflare Says GLM-5.3 Bug Leaked 155 Responses Across Tenant Sessions. Miles Okada
- BigGo Finance (Oct 27, 2026). Cloudflare Confirms AI Platform Data Leak: 155 Responses Mixed With Other Users' Requests, Ultra-Long Contexts Blamed — BigGo Finance. BigGo Finance
- Cloudflare (Oct 26, 2026). Cross-request KV cache exposure in the GLM-5.3 Workers AI model (155 responses)
- LLMLearner (Sep 5, 2026). GLM-5.3 Benchmark Results Analysis & Model Comparisons
- explainx.ai (Jun 29, 2026). GLM-5.3 Vision: Zhipu Community Wishlist Explained. Yash Thakker
- Turing Post (May 4, 2024). Zhipu AI (Z.ai): Founders, GLM Models, and Hong Kong IPO. Ksenia Se
- Tech AI Wire (Aug 31, 2026). GLM-5.3 weights ship under a custom license and need eight .... Tech AI Wire Team
- NIST (Sep 17, 2026). CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities
- lmsys.org (Oct 26, 2026). SGLang security update: improving request isolation - LMSYS Org
- Emergent (Aug 20, 2026). GLM 5.3 Review: What the AI Community Is Actually Saying
- LLM Stats (Aug 14, 2026). GLM-5.3 vs Kimi K3: Benchmarks, Pricing & Which Is Better in 2026. LLM Stats
- Cloudflare (Mar 19, 2026). Powering the agents: Workers AI now runs large models, starting with Kimi K2.5. Michelle Chen
Laatst bijgewerkt op 27 okt 2026. Dit artikel is gebaseerd op berichtgeving en data uit deze bronnen; de links in de tekst verwijzen naar de belangrijkste.
Reacties
Nog geen reacties. Laat als eerste weten wat je van dit artikel vindt.