Η κυκλοφορία του GLM-5.3 της Cloudflare δεν πήγε καλά, αλλά το πρόβλημα δεν ήταν το μοντέλο
Το GLM-5.3 είναι ένα οικονομικό και αποδοτικό μοντέλο κωδικοποίησης της Z.ai. Οι πρώτες εβδομάδες λειτουργίας του στο Workers AI της Cloudflare σημαδεύτηκαν από μια διαρροή που προκλήθηκε από σφάλμα κατά την ανάπτυξη και τη δοκιμή. Ακολουθεί περιγραφή του τι συνέβη και τι πρέπει να κάνετε.
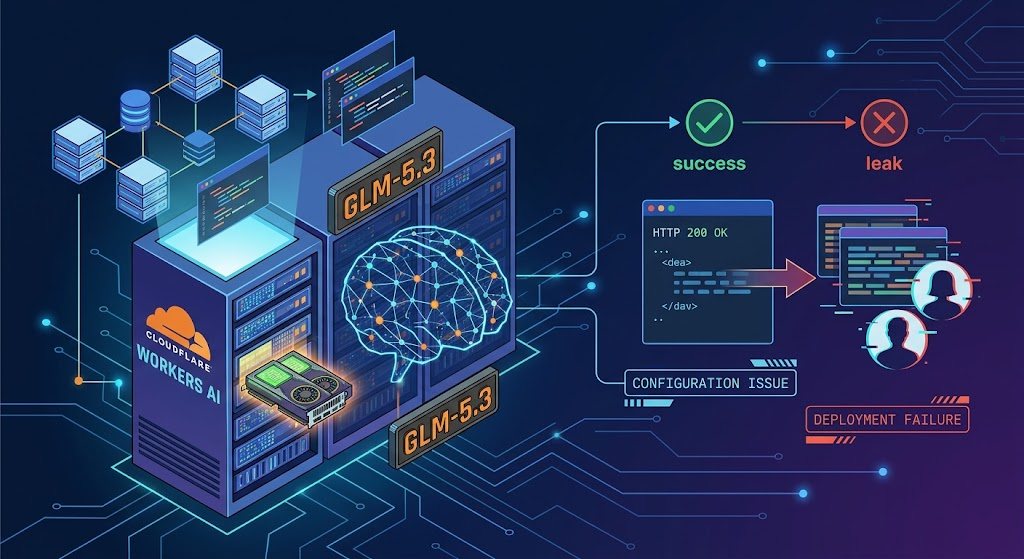
Κάθε προγραμματιστής γνωρίζει εκείνη τη μικρή αίσθηση ανησυχίας που προκαλεί ένα πράσινο σημάδι επιτυχίας στο οποίο δεν μπορείς να εμπιστευτείς απόλυτα. Για περίπου δύο εβδομάδες, ένας κωδικός επιτυχίας έκρυβε ένα πρόβλημα: 155 απαντήσεις σε εξαιρετικά μακρές προτροπές περιείχαν τμήματα από τις συνεδρίες άλλων πελατών. Η ιστορία δεν αφορά ένα ελαττωματικό μοντέλο, αλλά τον τρόπο με τον οποίο αυτό κυκλοφόρησε και δοκιμάστηκε.
Το GLM-5.3 είναι το μοντέλο δημιουργίας κειμένου της Z.ai, το οποίο έχει σχεδιαστεί για ροές εργασίας κωδικοποίησης με βάση την πράξη, και η Cloudflare το προσφέρει μέσω της υπηρεσίας Workers AI.
Η διαρροή διήρκεσε από τις 27 Αυγούστου έως τις 9 Σεπτεμβρίου 2026, σύμφωνα με την έκθεση περιστατικού της Cloudflare της 26ης Οκτωβρίου. Η άποψή μας: η αιτία δεν ήταν το μοντέλο ούτε κάποια επίθεση, αλλά μια επιλογή διαμόρφωσης σε συνδυασμό με ένα σφάλμα στον μηχανισμό εξαγωγής συμπερασμάτων. Οι συντελεστές βαρύτητας του μοντέλου δεν έπαιξαν κανένα ρόλο.
Τι είναι λοιπόν ακριβώς το GLM-5.3;
Η Z.ai ήταν γνωστή ως Zhipu AI μέχρι την αλλαγή της επωνυμίας της σε διεθνές επίπεδο τον Ιούλιο του 2025, ενώ η εταιρεία προήλθε από μια ερευνητική ομάδα του Πανεπιστημίου Τσινγκχούα. Η οικογένεια μοντέλων GLM ξεκίνησε τον Δεκέμβριο του 2021 ως ένα δίγλωσσο πρόγραμμα μοντέλου κινεζικών-αγγλικών. Το GLM-5.3 κυκλοφόρησε στις 14 Αυγούστου 2026 και, σύμφωνα με την κάρτα μοντέλου της Z.ai, βασίζεται στο βασικό μοντέλο του GLM-5.2, ενώ κάθε βελτίωση προέρχεται από την επανεκπαίδευση.
Στην ουσία, πρόκειται για ένα μοντέλο τύπου «mixture-of-experts», που σημαίνει ότι μόνο ένα μέρος των παραμέτρων του, περίπου 40 δισεκατομμύρια, χρησιμοποιούνται για κάθε token. Οι συντελεστές βάρους αναρτήθηκαν στο Hugging Face στις 31 Αυγούστου 2026 υπό μια ειδική άδεια χρήσης της Z.ai και όχι υπό την άδεια MIT.
Στο Workers AI, η Cloudflare εκτελεί το μοντέλο στις δικές της GPU, οπότε οι προγραμματιστές το καλούν με το όνομά του, αντί να διαχειρίζονται τον εξοπλισμό.
Τι ακριβώς πήγε στραβά στις 9 Σεπτεμβρίου;
Το πρόβλημα ξεκίνησε από μια αναντιστοιχία που ήταν γνωστή πριν από την έναρξη λειτουργίας. Το μοντέλο τέθηκε σε λειτουργία με παράθυρο συμφραζομένων 1.048.576 token, αλλά η μνήμη cache στις GPU προπλήρωσης είχε χωρητικότητα μόνο για 681.280. Η ομάδα το γνώριζε και το έκρινε αβλαβές, καθώς οι δοκιμές με μακρύ πλαίσιο έδωσαν επιτυχείς απαντήσεις.
Στη συνέχεια, το σφάλμα του κινητήρα μετέτρεψε αυτό το κενό σε διαρροή. Στη λειτουργία αποσύνθεσης του SGLang, τα αιτήματα που ξεπερνούσαν το επιτρεπόμενο μήκος επισημαίνονταν ως απορριφθέντα, αντικαθίσταντο από έναν προσωρινό χαρακτήρα ενός token και προωθούνταν, ενώ ο αποκωδικοποιητής διάβαζε παλιές σελίδες της κρυφής μνήμης από προηγούμενα αιτήματα. Οι πελάτες λάμβαναν κωδικό HTTP 200 αντί για σφάλμα. Ένας άλλος χρήστης είχε επισημάνει δημόσια το ελάττωμα στις 6 Ιουλίου 2026, οπότε η προειδοποίηση υπήρχε πολύ πριν εντοπιστεί η διαρροή. Αυτός είναι ο λόγος για τον οποίο ένας πράσινος κωδικός κατάστασης δεν αποτελεί απόδειξη μιας σωστής απόκρισης.
Μόλις ένας ερευνητής επισήμανε τη διαρροή, η αντίδραση δεν άργησε παρά μία μόνο ημέρα. Ο ερευνητής ασφάλειας Gadi Evron της Knostic την ανέφερε μέσω του HackerOne στις 8 Σεπτεμβρίου 2026. Η επαλήθευση ξεκίνησε στις 08:00 UTC την επόμενη μέρα, και το περιστατικό αναγνωρίστηκε ως τέτοιο στις 13:22, αφού η διαρροή αναπαράχθηκε με δύο λογαριασμούς. Το μοντέλο τέθηκε σε ιδιωτική λειτουργία στις 14:00 και επανήλθε στις 19:40 UTC. Η επιδιόρθωση ήταν γρήγορη μόλις κάποιος ανέφερε το πρόβλημα, αλλά η ίδια η διαρροή παρέμεινε απαρατήρητη για περίπου δύο εβδομάδες.
Το πόσο καιρό παρέμεινε εκτός λειτουργίας το μοντέλο εξαρτάται από το ποιος το μετράει. Ορισμένες εκτιμήσεις τοποθετούν τη διάρκεια της διακοπής σε περίπου 20 ώρες, αλλά αυτή η μέτρηση ξεκινά από τη στιγμή της αναφοράς, ενώ η Cloudflare μετρά τη διακοπή με βάση τα δικά της χρονικά δεδομένα. Η επιδιόρθωση δοκιμάστηκε σε σχέση με την αναπαραγωγή του προβλήματος από τον ίδιο τον ερευνητή και τις δοκιμές με δείκτες «canary», πριν το μοντέλο επανέλθει εκείνο το βράδυ, ενώ το έργο SGLang ενημερώθηκε την ίδια ημέρα.
Με αριθμούς
- 155: απαντήσεις που επιβεβαιώθηκαν ως επηρεασμένες, όλες σε ερωτήσεις με πάνω από 681.280 tokens
- 1.048.576: λέξεις-κλειδιά στο παράθυρο συμφραζομένων του GLM-5.3
- 128K: μονάδες μέγιστης απόδοσης
- 2,04 εκατομμύρια: ο αριθμός των token που διαθέτει πλέον το prefill pool
- 14:00 έως 19:40 UTC: ο χρόνος εκτός λειτουργίας του μοντέλου στις 9 Σεπτεμβρίου 2026
- 1: το μοντέλο επηρεάζεται, καθώς άλλες εγκαταστάσεις διαθέτουν μεγαλύτερες ομάδες cache
Γιατί όλα αυτά βγαίνουν στην επιφάνεια τώρα;
Η πλήρης αναφορά δημοσιεύθηκε με καθυστέρηση. Η έκθεση κυκλοφόρησε περίπου επτά εβδομάδες μετά την επιδιόρθωση. Αυτό συνέβη μετά τον ενθουσιασμό που προκάλεσε η κυκλοφορία του μοντέλου και μετά από μια αξιολόγηση ασφάλειας από το CAISI, το οποίο αποτελεί μέρος του αμερικανικού οργανισμού τυποποίησης NIST. Θα ακολουθήσουν περισσότερες πληροφορίες, καθώς η έκθεση του ίδιου του ερευνητή σχετικά με την ανακάλυψη και την επικύρωση αναμένεται να δημοσιευθεί αργότερα.
Η CAISI διαπίστωσε ότι το GLM-5.3 είναι το μοντέλο ανοιχτού βάρους με τις μεγαλύτερες δυνατότητες στον κυβερνοχώρο που έχει κυκλοφορήσει μέχρι σήμερα, αν και οι ικανότητές του στον κυβερνοχώρο υπολείπονται σημαντικά σε σχέση με τα τρέχοντα πρωτοποριακά μοντέλα των ΗΠΑ. Η εκτίμησή της κάνει λόγο για καθυστέρηση περίπου τεσσάρων μηνών, ενώ αξιολόγησε το GLM-5.3 ως ανώτερο από το Kimi K3. Αυτή η εκτίμηση αποτελεί έναν από τους λόγους για τους οποίους η είδηση δημοσιεύθηκε τη συγκεκριμένη στιγμή.
Η συζήτηση διχάστηκε σύμφωνα με τις γνωστές γραμμές. Ο Γκρεγκ Μπρόκμαν της OpenAI προειδοποίησε ότι το μοντέλο «open-weight» ενδέχεται να επιταχύνει την εξάπλωση των απειλών, ενώ ο πρώην αναλυτής του Υπουργείου Άμυνας Τζέικ Γουίλιαμς υποστήριξε ότι οι επιτιθέμενοι διαθέτουν ήδη παρόμοια εργαλεία. Και οι δύο πλευρές φαίνονται υπερβολικά έντονες, καθώς η ίδια η εκτίμηση του CAISI βρίσκεται κάπου ανάμεσά τους. Για εσάς, αυτό σημαίνει ότι πρέπει να επιλέξετε ένα μοντέλο με βάση την απόδοσή του και τον τρόπο ανάπτυξής του, και όχι με βάση τον πιο εντυπωσιακό τίτλο σχετικά με την ασφάλεια.
Είναι καλό και είναι φθηνό;
Τα πιο εντυπωσιακά αποτελέσματα είναι αυτά της ίδιας της Z.ai. Σύμφωνα με την περιγραφή του μοντέλου της, επιτυγχάνεται βελτίωση 50% στο εσωτερικό της τεστ Code Bench, ωστόσο το ίδιο το εργαστήριο αναφέρει ότι το Fable 5 εξακολουθεί να κατέχει την πρώτη θέση. Οι ανεξάρτητες αξιολογήσεις είναι πιο μετριοπαθείς, οπότε προτιμήστε τις εξωτερικές δοκιμές αντί για τη σελίδα παρουσίασης του προϊόντος.
Σε σύγκριση με το Kimi K3, τον πιο κοντινό ανταγωνιστή, το αποτέλεσμα είναι σχεδόν ισοπαλία. Το Kimi K3 κερδίζει σε 5 από τα 9 κοινά κριτήρια αξιολόγησης και δέχεται επίσης εικόνες, κάτι που το GLM-5.3 δεν κάνει. Το παράθυρο περιβάλλοντος είναι πανομοιότυπο, ενώ το Kimi K3 διαθέτει πολύ περισσότερες παραμέτρους.
Η τιμή είναι ο τομέας όπου το GLM-5.3 ξεχωρίζει. Η τιμή καταλόγου της Z.ai είναι 1,40 δολάρια ανά εκατομμύριο token εισόδου, και το μοντέλο αποδεικνύεται περίπου 3,0 φορές φθηνότερο ανά token σε σχέση με το Kimi K3. Ωστόσο, οι τιμές καταλόγου υποτιμούν το κόστος των μακροχρόνιων εκτελέσεων του πράκτορα, καθώς μια εργασία που απαιτεί μέγιστη προσπάθεια κοστίζει περισσότερο από μια εργασία χαμηλής προσπάθειας.
Υπάρχει ένα σημαντικό κενό εδώ: τα στοιχεία δεν περιλαμβάνουν καμία τιμή της Workers AI για το GLM-5.3, ενώ η σελίδα σύγκρισης δεν αναφέρει καθόλου την Workers AI. Το πλεονέκτημα κόστους είναι πιθανώς πραγματικό στις τιμές της Z.ai, ενώ δεν έχει αποδειχθεί όσον αφορά την Workers AI.
Τι σημαίνει αν βασιστείτε στο Workers AI
Η άποψή μας είναι ότι το GLM-5.3 ταιριάζει σε ομάδες που αναπτύσσουν προγράμματα-πράκτορες ή ροές εργασίας ελέγχου κώδικα και επιθυμούν ένα ισχυρό ανοιχτό μοντέλο χωρίς να χρειάζεται να διαχειρίζονται GPU. Η εναλλακτική λύση είναι η αυτο-φιλοξενία, η οποία απαιτεί τουλάχιστον 8 GPU κατηγορίας H200 ή ανώτερης, οπότε έχει νόημα μόνο αν επιθυμείτε να έχετε τον έλεγχο του δικού σας υλικού. Δεν είναι τόσο κατάλληλο για ευαίσθητα δεδομένα με εξαιρετικά μεγάλα μήκη περιβάλλοντος, για ομάδες που χρειάζονται τεχνολογίες όρασης ή για αγοραστές που υπόκεινται σε περιορισμούς προμηθειών από προμηθευτές της Λαϊκής Δημοκρατίας της Κίνας.
Υπάρχουν μερικές πρακτικές που βοηθούν. Στείλτε μια κεφαλίδα x-session-affinity για τις συνεδρίες των πρακτόρων, περιορίστε το μήκος των προτροπών στην πύλη σας και ελέγξτε το περιεχόμενο της εξόδου και όχι μόνο τους κωδικούς κατάστασης. Η αναφορά συμβάντος είναι το κατάλληλο μέρος για να ελέγξετε αν ο λογαριασμός σας συγκαταλέγεται στα αιτήματα που επηρεάστηκαν.
Η χωρητικότητα του serverless είναι κοινόχρηστη και δεν υπάρχει αυστηρή εγγύηση επεξεργασίας. Αυτό έχει σημασία, καθώς το ασύγχρονο API αποτελεί τη συνιστώμενη προσέγγιση για ανθεκτικές ροές εργασίας, οπότε οι ομάδες με εργασίες μακράς διάρκειας θα πρέπει να ξεκινήσουν από εκεί. Πριν προχωρήσετε στην υιοθέτηση, ελέγξτε την τρέχουσα σελίδα τιμολόγησης του Workers AI και αξιολογήστε την απόδοση του μοντέλου στις δικές σας εργασίες.
Προς τα πού οδηγεί αυτό
Θεωρούμε ότι το GLM-5.3 είναι ένα αξιόπιστο μοντέλο κωδικοποίησης χαμηλού κόστους, το οποίο βρίσκεται ένα βήμα πίσω από τα μοντέλα κλειστού ορίου. Ο αριθμός των επηρεαζόμενων απαντήσεων δείχνει περιορισμένη βλάβη, χωρίς όμως να αποκλείεται η ύπαρξη βλάβης.
Το βασικό σενάριο προβλέπει σταθερή ανάπτυξη μεταξύ των προγραμματιστών που δίνουν έμφαση στο κόστος, υπό την προϋπόθεση ότι θα διατηρηθούν η μεγαλύτερη ομάδα cache και η διόρθωση της έκδοσης SGLang v0.5.22. Ο κίνδυνος είναι ότι περαιτέρω λεπτομέρειες θα υπονομεύσουν την εμπιστοσύνη και οι επιφυλακτικές επιχειρήσεις θα στραφούν προς κλειστά ή άλλα μοντέλα φιλοξενίας. Να παρακολουθείτε τυχόν αναθεωρήσεις του αριθμού των επηρεαζόμενων συστημάτων και αλλαγές στον τρόπο δοκιμής του μοντέλου.
Όσον αφορά τις δυνατότητες, ενδέχεται να ακολουθήσει μια ακόμη γρήγορη έκδοση του Z.ai, ενώ η τετράμηνη καθυστέρηση του CAISI αποτελεί μια στιγμιαία εικόνα. Η εξατομικευμένη άδεια χρήσης και η σταδιακή κυκλοφορία ενδέχεται να επηρεάσουν το ποιος θα το υιοθετήσει. Τα επόμενα στοιχεία που πρέπει να ελέγξετε: η δημοσιευμένη τιμή του Workers AI, η έκθεση του ερευνητή και τα νέα αποτελέσματα του CAISI.
Πηγές 12unite.ai, BigGo Finance, Cloudflare και 9 ακόμη πηγές
- unite.ai (Oct 26, 2026). Cloudflare Says GLM-5.3 Bug Leaked 155 Responses Across Tenant Sessions. Miles Okada
- BigGo Finance (Oct 27, 2026). Cloudflare Confirms AI Platform Data Leak: 155 Responses Mixed With Other Users' Requests, Ultra-Long Contexts Blamed — BigGo Finance. BigGo Finance
- Cloudflare (Oct 26, 2026). Cross-request KV cache exposure in the GLM-5.3 Workers AI model (155 responses)
- LLMLearner (Sep 5, 2026). GLM-5.3 Benchmark Results Analysis & Model Comparisons
- explainx.ai (Jun 29, 2026). GLM-5.3 Vision: Zhipu Community Wishlist Explained. Yash Thakker
- Turing Post (May 4, 2024). Zhipu AI (Z.ai): Founders, GLM Models, and Hong Kong IPO. Ksenia Se
- Tech AI Wire (Aug 31, 2026). GLM-5.3 weights ship under a custom license and need eight .... Tech AI Wire Team
- NIST (Sep 17, 2026). CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities
- lmsys.org (Oct 26, 2026). SGLang security update: improving request isolation - LMSYS Org
- Emergent (Aug 20, 2026). GLM 5.3 Review: What the AI Community Is Actually Saying
- LLM Stats (Aug 14, 2026). GLM-5.3 vs Kimi K3: Benchmarks, Pricing & Which Is Better in 2026. LLM Stats
- Cloudflare (Mar 19, 2026). Powering the agents: Workers AI now runs large models, starting with Kimi K2.5. Michelle Chen
Τελευταία ενημέρωση: 27 Οκτ 2026. Το άρθρο βασίζεται σε ρεπορτάζ και δεδομένα από αυτές τις πηγές· οι σύνδεσμοι στο κείμενο οδηγούν στις σημαντικότερες.
Σχόλια
Δεν υπάρχουν ακόμη σχόλια. Γράψτε πρώτοι τη γνώμη σας για αυτό το άρθρο.