Die Einführung von Cloudflares GLM-5.3 verlief nicht wie geplant, doch das Modell war nicht das Problem
GLM-5.3 ist ein kostengünstiges, leistungsfähiges Modell von Z.ai. In den ersten Wochen nach der Einführung auf Cloudflares „Workers AI“ kam es aufgrund eines Fehlers bei der Bereitstellung und beim Testen zu einer Datenpanne. Hier erfahren Sie, was genau passiert ist und wie Sie vorgehen sollten.
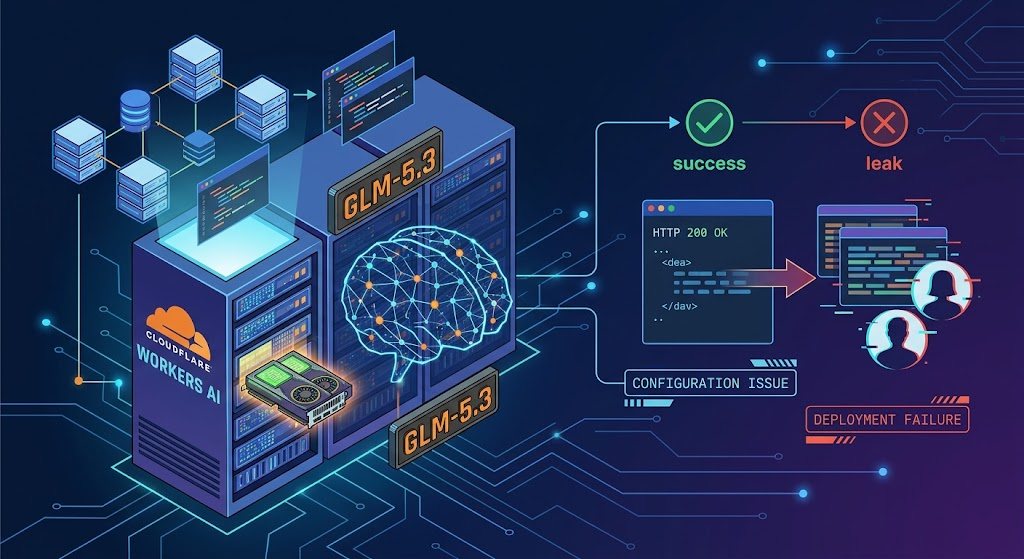
Jeder Entwickler kennt dieses leichte Unbehagen angesichts eines grünen Häkchens, dem man nicht ganz trauen kann. Etwa zwei Wochen lang verbarg ein Erfolgscode ein Problem: 155 Antworten auf besonders lange Eingabeaufforderungen enthielten Teile aus den Sitzungen anderer Kunden. In dieser Geschichte geht es nicht um ein fehlerhaftes Modell, sondern darum, wie es eingeführt und getestet wurde.
GLM-5.3 ist das Textgenerierungsmodell von Z.ai, das speziell für agentische Programmier-Workflows entwickelt wurde, und Cloudflare stellt es über Workers AI zur Verfügung.
Laut dem Vorfallbericht von Cloudflare vom 26. Oktober dauerte die Datenpanne vom 27. August bis zum 9. September 2026. Unsere Einschätzung: Die Ursache war weder das Modell noch ein Angriff, sondern eine Konfigurationsentscheidung in Verbindung mit einem Fehler in der Inferenz-Engine. Die Modellgewichte spielten keine Rolle.
Was genau ist GLM-5.3?
Z.ai war bis zu seiner internationalen Umfirmierung im Juli 2025 unter dem Namen Zhipu AI bekannt; das Unternehmen ging aus einer Forschungsgruppe der Tsinghua-Universität hervor. Die GLM-Familie entstand im Dezember 2021 als Projekt für ein zweisprachiges Chinesisch-Englisch-Modell. GLM-5.3 wurde am 14. August 2026 eingeführt, und laut der Modellbeschreibung von Z.ai basiert es auf dem Basismodell hinter GLM-5.2, wobei alle Verbesserungen aus dem Nachtraining stammen.
Im Hintergrund handelt es sich um ein „Mixture-of-Experts“-Modell, was bedeutet, dass bei jedem Token nur ein Teil der Parameter – etwa 40 Milliarden – zum Einsatz kommt. Die Gewichte wurden am 31. August 2026 auf Hugging Face unter einer benutzerdefinierten Z.ai-Lizenz statt unter der MIT-Lizenz veröffentlicht.
Bei „Workers AI“ führt Cloudflare das Modell auf seinen eigenen GPUs aus, sodass Entwickler es direkt aufrufen können, anstatt sich um die Hardware kümmern zu müssen.
Was ist am 9. September eigentlich schiefgelaufen?
Die Probleme begannen mit einer Diskrepanz, die bereits vor dem Start bekannt war. Das Modell wurde mit einem Kontextfenster von 1.048.576 Tokens gestartet, doch der Cache auf den für das Prefill zuständigen GPUs bot nur Platz für 681.280. Das Team wusste davon und hielt dies für unbedenklich, da die Tests mit langen Kontexten erfolgreiche Ergebnisse lieferten.
Dann verwandelte der Motorfehler diese Lücke in eine Sicherheitslücke. Im disaggregierten Modus von SGLang wurden überlange Anfragen als abgelehnt markiert, durch einen Platzhalter aus einem Token ersetzt und weitergeleitet, und der Decoder las veraltete Cache-Seiten aus früheren Anfragen aus. Clients erhielten einen HTTP-200-Status statt einer Fehlermeldung. Ein anderer Nutzer hatte den Fehler bereits am 6. Juli 2026 öffentlich gemeldet, sodass die Warnung schon lange vor der Entdeckung der Sicherheitslücke vorlag. Deshalb ist ein grüner Statuscode kein Beweis für eine fehlerfreie Antwort.
Sobald ein Forscher die Sicherheitslücke gemeldet hatte, dauerte die Reaktion nur einen Tag. Der Sicherheitsforscher Gadi Evron von Knostic meldete den Vorfall am 8. September 2026 über HackerOne. Die Überprüfung begann am nächsten Tag um 08:00 Uhr UTC, und um 13:22 Uhr wurde ein Vorfall gemeldet, nachdem die Sicherheitslücke mit zwei Konten reproduziert werden konnte. Das Modell wurde um 14:00 Uhr auf „privat“ gesetzt und um 19:40 Uhr UTC wieder freigeschaltet. Die Behebung erfolgte zügig, sobald jemand das Problem gemeldet hatte, doch die Sicherheitslücke selbst blieb etwa zwei Wochen lang unentdeckt.
Wie lange das Modell ausgefallen war, hängt davon ab, wer die Zeit misst. Einige Schätzungen gehen von einer Ausfallzeit von etwa 20 Stunden aus, doch diese Zeitrechnung beginnt erst mit der Meldung, während Cloudflare selbst die Dauer des Ausfalls misst. Die Korrektur wurde anhand der vom Forscher selbst erstellten Reproduktion sowie anhand seiner Canary-Marker-Tests getestet, bevor das Modell am Abend wieder verfügbar war, und das SGLang-Projekt wurde noch am selben Tag darüber informiert.
In Zahlen
- 155: Antworten, bei denen eine Beeinträchtigung bestätigt wurde, alle auf Eingaben mit mehr als 681.280 Tokens
- 1.048.576: Token im GLM-5.3-Kontextfenster
- 128K: Token bei maximaler Ausgabe
- 2,04 Millionen: Anzahl der Token, die sich derzeit im Prefill-Pool befinden
- 14:00 bis 19:40 UTC: Die Ausfallzeit des Modells am 9. September 2026
- 1: Das Modell ist davon betroffen, da andere Bereitstellungen über größere Cache-Pools verfügen
Warum kommt das alles gerade jetzt ans Licht?
Der vollständige Bericht traf erst spät ein. Er wurde etwa sieben Wochen nach der Behebung des Problems veröffentlicht. Dies geschah, nachdem der Hype um die Markteinführung des Modells bereits abgeklungen war und eine Sicherheitsbewertung durch CAISI, eine Abteilung der US-Normungsorganisation NIST, vorlag. Weitere Informationen werden folgen, da der eigene Bericht des Forschers über die Entdeckung und Validierung des Problems noch aussteht.
CAISI stufte GLM-5.3 als das bislang leistungsfähigste Open-Weight-Modell im Bereich Cybersicherheit ein, auch wenn seine Fähigkeiten in diesem Bereich deutlich hinter den aktuellen Spitzenmodellen der USA zurückbleiben. Die Schätzung geht von einer Verzögerung von etwa vier Monaten aus, und GLM-5.3 wurde besser bewertet als Kimi K3. Diese Einschätzung ist einer der Gründe, warum der Bericht gerade zu diesem Zeitpunkt erschien.
Die Debatte verlief entlang bekannter Fronten. Greg Brockman von OpenAI warnte, dass das Open-Weight-Modell die Bedrohungslage wahrscheinlich beschleunigen werde, während der ehemalige Analyst des Verteidigungsministeriums, Jake Williams, argumentierte, dass Angreifer bereits über vergleichbare Werkzeuge verfügten. Beide Lager wirken überhitzt, da das eigene Urteil von CAISI genau dazwischen liegt. Für Sie bedeutet das, dass Sie ein Modell danach auswählen sollten, wie es funktioniert und wie es eingesetzt wird – und nicht danach, welche Sicherheitsschlagzeile am lautesten ist.
Ist es gut, und ist es günstig?
Die beeindruckendsten Zahlen stammen von Z.ai selbst. Laut der Modellbeschreibung soll eine Verbesserung von 50 % im hauseigenen „Code Bench“-Test erzielt worden sein, doch das Labor selbst berichtet, dass Fable 5 nach wie vor die Nase vorn hat. Unabhängige Bewertungen fallen bescheidener aus, daher sollte man externen Tests mehr Vertrauen schenken als den Angaben auf der Startseite.
Gegenüber Kimi K3, dem engsten Konkurrenten, ist das Ergebnis nahezu ausgeglichen. Kimi K3 gewinnt 5 von 9 gemeinsamen Benchmarks und akzeptiert zudem Bilder, was bei GLM-5.3 nicht der Fall ist. Das Kontextfenster ist identisch, und Kimi K3 verfügt über weitaus mehr Parameter.
Beim Preis hat GLM-5.3 die Nase vorn. Der Listenpreis von Z.ai liegt bei 1,40 US-Dollar pro Million Eingabetoken, und das Modell ist pro Token etwa 3,0-mal günstiger als Kimi K3. Die Listenpreise unterschätzen jedoch lange Agentenläufe, da eine Aufgabe mit maximalem Aufwand mehr kostet als eine mit geringem Aufwand.
Ein Punkt ist hier entscheidend: In den Daten ist kein Preis von Workers AI für GLM-5.3 aufgeführt, und auf der Vergleichsseite wird Workers AI überhaupt nicht erwähnt. Der Kostenvorteil ist bei den Preisen von Z.ai wahrscheinlich real, bei Workers AI hingegen nicht belegt.
Was es bedeutet, wenn Sie auf Workers AI aufbauen
Unserer Einschätzung nach eignet sich GLM-5.3 für Teams, die Programmieragenten oder Code-Review-Pipelines entwickeln und ein leistungsstarkes offenes Modell nutzen möchten, ohne sich um die Verwaltung von GPUs kümmern zu müssen. Die Alternative ist das Self-Hosting, wofür mindestens 8 GPUs der H200-Klasse oder besser erforderlich sind; dies ist daher nur dann sinnvoll, wenn Sie die Kontrolle über Ihre eigene Hardware behalten möchten. Es eignet sich weniger gut für sensible Daten bei extremen Kontextlängen, für Teams, die Bildverarbeitung benötigen, oder für Käufer mit Beschaffungsbeschränkungen für Anbieter aus der VR China.
Einige Maßnahmen können dabei helfen: Senden Sie für Agent-Sitzungen einen „x-session-affinity“-Header, begrenzen Sie die Länge der Eingabeaufforderung in Ihrem eigenen Gateway und überprüfen Sie den Inhalt der Ausgabe statt nur die Statuscodes. Im Vorfallbericht können Sie nachsehen, ob Ihr Konto zu den betroffenen Anfragen gehörte.
Die serverlose Kapazität wird gemeinsam genutzt, und es gibt keine strikte Garantie für die Verarbeitung. Das ist wichtig, da die asynchrone API der empfohlene Weg für dauerhafte Workflows ist; daher sollten Teams mit lang laufenden Jobs dort beginnen. Informieren Sie sich vor der Einführung auf der aktuellen Preisseite von Workers AI und führen Sie einen Benchmark des Modells für Ihre eigenen Aufgaben durch.
Wohin das führen wird
Wir halten GLM-5.3 für ein glaubwürdiges, kostengünstiges Kodierungsmodell, das jedoch einen Schritt hinter den Closed-Frontier-Modellen zurückbleibt. Die Anzahl der betroffenen Antworten deutet auf einen begrenzten Schaden hin, was jedoch nicht bedeutet, dass ein Schaden ausgeschlossen wäre.
Das Basisszenario geht von einem stetigen Wachstum bei kostenbewussten Codierungsagenten aus, solange der größere Cache-Pool und der Fix in SGLang v0.5.22 Bestand haben. Das Risiko besteht darin, dass weitere Details das Vertrauen untergraben und vorsichtige Unternehmen zu geschlossenen oder anderen gehosteten Modellen abwandern. Achten Sie auf etwaige Korrekturen der Anzahl der betroffenen Fälle sowie auf Änderungen bei der Art und Weise, wie das Modell getestet wird.
Was die Leistungsfähigkeit angeht, könnte es bald eine weitere Z.ai-Version geben, und der viermonatige Rückstand von CAISI ist nur eine Momentaufnahme. Die maßgeschneiderte Lizenz und die schrittweise Einführung könnten Einfluss darauf haben, wer das System nutzt. Was Sie als Nächstes im Auge behalten sollten: einen veröffentlichten Preis für Workers AI, den Bericht des Forschers und neue CAISI-Ergebnisse.
Quellen 12unite.ai, BigGo Finance, Cloudflare und 9 weitere Quellen
- unite.ai (Oct 26, 2026). Cloudflare Says GLM-5.3 Bug Leaked 155 Responses Across Tenant Sessions. Miles Okada
- BigGo Finance (Oct 27, 2026). Cloudflare Confirms AI Platform Data Leak: 155 Responses Mixed With Other Users' Requests, Ultra-Long Contexts Blamed — BigGo Finance. BigGo Finance
- Cloudflare (Oct 26, 2026). Cross-request KV cache exposure in the GLM-5.3 Workers AI model (155 responses)
- LLMLearner (Sep 5, 2026). GLM-5.3 Benchmark Results Analysis & Model Comparisons
- explainx.ai (Jun 29, 2026). GLM-5.3 Vision: Zhipu Community Wishlist Explained. Yash Thakker
- Turing Post (May 4, 2024). Zhipu AI (Z.ai): Founders, GLM Models, and Hong Kong IPO. Ksenia Se
- Tech AI Wire (Aug 31, 2026). GLM-5.3 weights ship under a custom license and need eight .... Tech AI Wire Team
- NIST (Sep 17, 2026). CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities
- lmsys.org (Oct 26, 2026). SGLang security update: improving request isolation - LMSYS Org
- Emergent (Aug 20, 2026). GLM 5.3 Review: What the AI Community Is Actually Saying
- LLM Stats (Aug 14, 2026). GLM-5.3 vs Kimi K3: Benchmarks, Pricing & Which Is Better in 2026. LLM Stats
- Cloudflare (Mar 19, 2026). Powering the agents: Workers AI now runs large models, starting with Kimi K2.5. Michelle Chen
Zuletzt aktualisiert: 27. Okt 2026. Dieser Artikel stützt sich auf Berichte und Daten aus diesen Quellen; die Links im Text führen zu den wichtigsten.
Kommentare
Noch keine Kommentare. Schreib als Erstes, was du von diesem Beitrag hältst.