Il lancio del GLM-5.3 di Cloudflare è andato male, ma il problema non era il modello
GLM-5.3 è un modello di codifica economico ed efficiente sviluppato da Z.ai. Le sue prime settimane su Workers AI di Cloudflare sono state caratterizzate da una fuga di dati causata da un errore durante la distribuzione e il collaudo. Ecco cosa è successo e cosa fare.
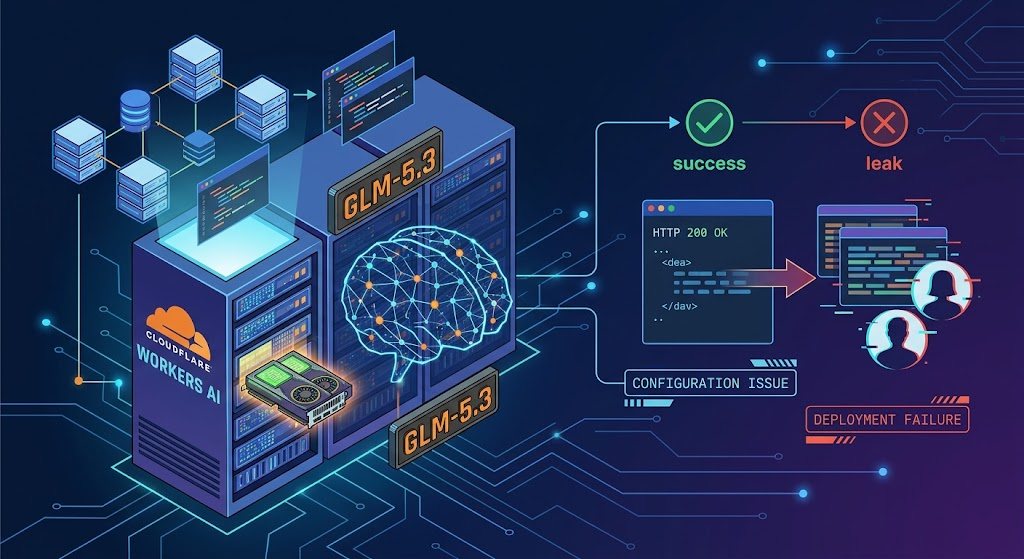
Ogni sviluppatore conosce quel leggero brivido che provoca un segno di spunta verde di cui non ci si può fidare del tutto. Per circa due settimane, un codice di esito positivo ha nascosto un problema: 155 risposte a prompt particolarmente lunghi contenevano frammenti delle sessioni di altri clienti. La vicenda non riguarda un modello difettoso, ma il modo in cui è stato lanciato e testato.
GLM-5.3 è il modello di generazione di testo di Z.ai progettato per i flussi di lavoro di codifica agentica, e Cloudflare lo offre su Workers AI.
Secondo il rapporto sull'incidente di Cloudflare del 26 ottobre, la fuga di dati si è protratta dal 27 agosto al 9 settembre 2026. La nostra opinione: la causa non è stata né il modello né un attacco, bensì una scelta di configurazione unita a un bug nel motore di inferenza. I pesi del modello non hanno avuto alcun ruolo.
Ma cos’è esattamente il GLM-5.3?
Z.ai era nota come Zhipu AI fino al rebranding internazionale avvenuto nel luglio 2025; l’azienda è nata da un gruppo di ricerca dell’Università di Tsinghua. La famiglia GLM ha avuto inizio nel dicembre 2021 come progetto di modello bilingue cinese-inglese. GLM-5.3 è stato lanciato il 14 agosto 2026 e, secondo la scheda tecnica di Z.ai, è basato sul modello di base alla base di GLM-5.2, con tutti i miglioramenti derivanti dal post-addestramento.
In sostanza, si tratta di un modello “mixture-of-experts”, il che significa che solo una parte dei suoi parametri, circa 40 miliardi, viene utilizzata per ogni token. I pesi sono stati resi disponibili su Hugging Face il 31 agosto 2026 con una licenza personalizzata di Z.ai anziché con la licenza MIT.
Su Workers AI, Cloudflare esegue il modello sulle proprie GPU, quindi gli sviluppatori lo richiamano per nome invece di doversi occupare della gestione dell'hardware.
Cosa è andato storto, in realtà, il 9 settembre?
Il problema è iniziato con un disallineamento già noto prima del lancio. Il modello è stato lanciato con una finestra di contesto di 1.048.576 token, ma la cache delle GPU di prefill aveva spazio solo per 681.280. Il team ne era a conoscenza e lo aveva ritenuto innocuo, poiché i test con contesti lunghi avevano restituito risposte positive.
Poi il bug del motore ha trasformato quella falla in una vulnerabilità. Nella modalità disaggregata di SGLang, le richieste troppo lunghe venivano contrassegnate come rifiutate, sostituite con un segnaposto di un solo token e inoltrate, e il decodificatore leggeva pagine di cache non aggiornate provenienti da richieste precedenti. I client ricevevano un codice di stato HTTP 200 invece di un errore. Un altro utente aveva segnalato pubblicamente la vulnerabilità il 6 luglio 2026, quindi l’avviso esisteva già molto prima che la fuga di dati venisse individuata. Ecco perché un codice di stato verde non è prova di una risposta corretta.
Non appena un ricercatore ha segnalato la falla, la risposta è arrivata nel giro di un solo giorno. Il ricercatore di sicurezza Gadi Evron di Knostic ha segnalato il problema tramite HackerOne l’8 settembre 2026. La verifica è iniziata alle 08:00 UTC del giorno successivo e l’incidente è stato dichiarato alle 13:22, dopo che la fuga di dati è stata riprodotta con due account. Il modello è stato reso privato alle 14:00 ed è tornato disponibile alle 19:40 UTC. La correzione è stata rapida una volta segnalato il problema, ma la falla stessa è rimasta inosservata per circa due settimane.
La durata dell’interruzione del modello dipende da chi la calcola. Alcune stime indicano un periodo di inattività di circa 20 ore, ma tale conteggio parte dalla segnalazione, mentre sono i tempi riportati da Cloudflare a determinare la durata dell’interruzione. La correzione è stata testata sulla riproduzione effettuata dal ricercatore stesso e tramite i test con i marcatori canary prima che il modello tornasse operativo quella sera stessa, e il progetto SGLang ne è stato informato lo stesso giorno.
I numeri parlano chiaro
- 155: risposte confermate come interessate dal problema, tutte relative a prompt di oltre 681.280 token
- 1.048.576: token nella finestra di contesto del GLM-5.3
- 128K: numero massimo di token emessi
- 2,04 milioni: il numero di token attualmente presenti nel pool di precompilazione
- Dalle 14:00 alle 19:40 UTC: periodo di inattività del modello il 9 settembre 2026
- 1: modello interessato, poiché altre implementazioni dispongono di pool di cache più grandi
Perché tutto questo sta venendo alla luce proprio adesso?
Il resoconto completo è arrivato in ritardo. Il rapporto è stato pubblicato circa sette settimane dopo la correzione. È stato diffuso dopo il clamore suscitato dal lancio del modello e dopo una valutazione di sicurezza da parte del CAISI, che fa parte dell’ente statunitense di normazione NIST. Ci saranno ulteriori aggiornamenti, poiché il rapporto del ricercatore stesso sulla scoperta e sulla convalida è previsto per più avanti.
Il CAISI ha ritenuto che il GLM-5.3 sia il modello a peso libero con le migliori capacità informatiche tra quelli rilasciati finora, sebbene le sue competenze in questo ambito siano significativamente inferiori a quelle degli attuali modelli all’avanguardia statunitensi. Secondo le sue stime, il ritardo è di circa quattro mesi, e il GLM-5.3 è stato valutato al di sopra del Kimi K3. Tale valutazione è uno dei motivi per cui la notizia è stata diffusa proprio in quel momento.
Il dibattito si è articolato lungo linee già note. Greg Brockman di OpenAI ha avvertito che il modello a peso aperto rischia di accelerare l’evoluzione delle minacce, mentre l’ex analista del Dipartimento della Difesa Jake Williams ha sostenuto che gli aggressori dispongono già di strumenti simili. Entrambe le posizioni appaiono eccessive, poiché il verdetto dello stesso CAISI si colloca a metà strada tra le due. Per voi, ciò significa scegliere un modello in base alle sue prestazioni e alle modalità di implementazione, non in base al titolo più sensazionale in materia di sicurezza.
È un buon prodotto e costa poco?
I dati più lusinghieri sono quelli forniti dalla stessa Z.ai. La scheda tecnica del modello dichiara un miglioramento del 50% rispetto al proprio benchmark interno “Code Bench”, ma lo stesso laboratorio riferisce che Fable 5 è ancora in testa. I risultati delle valutazioni indipendenti sono più modesti, quindi è meglio affidarsi ai test esterni piuttosto che a quanto riportato nella pagina di lancio.
Rispetto a Kimi K3, il rivale più vicino, il risultato è quasi un pareggio. Kimi K3 vince 5 dei 9 benchmark condivisi e accetta anche immagini, cosa che GLM-5.3 non fa. La finestra di contesto è identica, mentre Kimi K3 è di gran lunga più ampio in termini di parametri.
È sul fronte del prezzo che GLM-5.3 si distingue. Il prezzo di listino di Z.ai è di 1,40 dollari per milione di token in ingresso, e il modello risulta circa 3,0 volte più economico per token rispetto a Kimi K3. I prezzi di listino sottostimano tuttavia le esecuzioni prolungate dell’agente, poiché un’attività che richiede il massimo impegno costa di più rispetto a una che ne richiede poco.
C'è un aspetto importante da sottolineare: i dati disponibili non riportano il prezzo di Workers AI per il modello GLM-5.3 e la pagina di confronto non menziona affatto Workers AI. Il vantaggio in termini di costo è probabilmente reale per i prezzi di Z.ai, mentre non è dimostrato per Workers AI.
Cosa significa sviluppare su Workers AI
A nostro avviso, GLM-5.3 è adatto ai team che sviluppano agenti di codifica o pipeline di revisione del codice e che desiderano un modello aperto e potente senza doversi occupare della gestione delle GPU. L’hosting autonomo rappresenta l’alternativa, ma richiede almeno 8 GPU di classe H200 o superiore, quindi è una scelta sensata solo se si desidera avere il controllo sul proprio hardware. È meno adatto per dati sensibili con lunghezze di contesto estreme, per i team che necessitano di visione artificiale o per gli acquirenti soggetti a limitazioni di approvvigionamento da fornitori della Repubblica Popolare Cinese.
Alcune buone pratiche possono essere d’aiuto. Invia un’intestazione `x-session-affinity` per le sessioni degli agenti, limita la lunghezza dei messaggi di prompt nel tuo gateway e verifica il contenuto dell’output anziché limitarti ai soli codici di stato. Il rapporto sull’incidente è il luogo in cui verificare se il tuo account figurava tra le richieste interessate.
La capacità serverless è condivisa e non vi è alcuna garanzia rigorosa di elaborazione. Questo è importante perché l’API asincrona è la soluzione consigliata per i flussi di lavoro persistenti, quindi i team con processi di lunga durata dovrebbero partire da lì. Prima di procedere all’adozione, consultate la pagina dei prezzi attuale di Workers AI ed effettuate un benchmark del modello sulle vostre attività.
Dove si sta andando a finire
Riteniamo che il GLM-5.3 sia un modello di codifica credibile e a basso costo, leggermente inferiore rispetto ai modelli a frontiera chiusa. Il numero di risposte interessate indica un danno limitato, ma ciò non significa che il danno sia stato escluso.
Lo scenario di base prevede una crescita costante tra gli agenti di codifica attenti ai costi, a condizione che il pool di cache più ampio e la correzione di SGLang v0.5.22 continuino a funzionare correttamente. Il rischio è che ulteriori dettagli minino la fiducia e che le aziende più caute si orientino verso modelli chiusi o altri modelli in hosting. Prestare attenzione a eventuali revisioni del numero di sistemi interessati e a modifiche alle modalità di test del modello.
Per quanto riguarda le funzionalità, potrebbe esserci un altro rilascio rapido di Z.ai, mentre il ritardo di quattro mesi di CAISI rappresenta solo un’istantanea della situazione. La licenza personalizzata e il rilascio graduale potrebbero influenzare chi deciderà di adottarlo. I prossimi elementi da verificare: il prezzo pubblicato di Workers AI, il rapporto del ricercatore e i nuovi risultati del CAISI.
Fonti 12unite.ai, BigGo Finance, Cloudflare e altre 9 fonti
- unite.ai (Oct 26, 2026). Cloudflare Says GLM-5.3 Bug Leaked 155 Responses Across Tenant Sessions. Miles Okada
- BigGo Finance (Oct 27, 2026). Cloudflare Confirms AI Platform Data Leak: 155 Responses Mixed With Other Users' Requests, Ultra-Long Contexts Blamed — BigGo Finance. BigGo Finance
- Cloudflare (Oct 26, 2026). Cross-request KV cache exposure in the GLM-5.3 Workers AI model (155 responses)
- LLMLearner (Sep 5, 2026). GLM-5.3 Benchmark Results Analysis & Model Comparisons
- explainx.ai (Jun 29, 2026). GLM-5.3 Vision: Zhipu Community Wishlist Explained. Yash Thakker
- Turing Post (May 4, 2024). Zhipu AI (Z.ai): Founders, GLM Models, and Hong Kong IPO. Ksenia Se
- Tech AI Wire (Aug 31, 2026). GLM-5.3 weights ship under a custom license and need eight .... Tech AI Wire Team
- NIST (Sep 17, 2026). CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities
- lmsys.org (Oct 26, 2026). SGLang security update: improving request isolation - LMSYS Org
- Emergent (Aug 20, 2026). GLM 5.3 Review: What the AI Community Is Actually Saying
- LLM Stats (Aug 14, 2026). GLM-5.3 vs Kimi K3: Benchmarks, Pricing & Which Is Better in 2026. LLM Stats
- Cloudflare (Mar 19, 2026). Powering the agents: Workers AI now runs large models, starting with Kimi K2.5. Michelle Chen
Ultimo aggiornamento: 27 ott 2026. Questo articolo si basa su notizie e dati di queste fonti; i link nel testo portano alle più importanti.
Commenti
Ancora nessun commento. Scrivi per primo che cosa ne pensi di questo articolo.