El lanzamiento del GLM-5.3 de Cloudflare salió mal, pero el problema no estaba en el modelo
GLM-5.3 es un modelo de codificación económico y eficaz de Z.ai. Sus primeras semanas en la plataforma Workers AI de Cloudflare se vieron marcadas por una fuga provocada por un fallo en la implementación y las pruebas. A continuación explicamos qué ocurrió y qué hay que hacer.
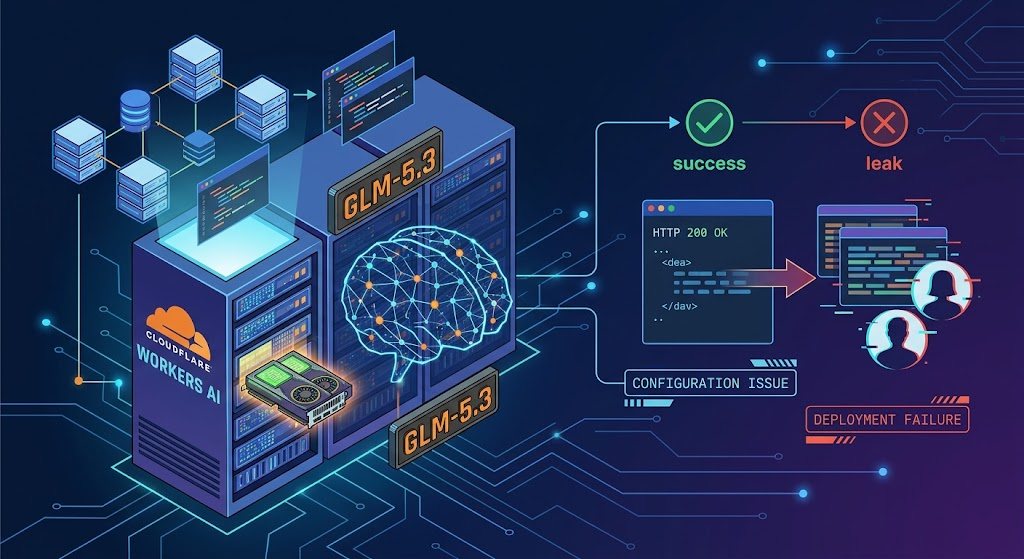
Todo desarrollador conoce esa ligera sensación de inquietud que produce una marca de verificación verde en la que no se puede confiar del todo. Durante unas dos semanas, un código de éxito ocultó un problema: 155 respuestas a solicitudes extremadamente largas contenían fragmentos de sesiones de otros clientes. La historia no trata de un modelo defectuoso, sino de cómo se lanzó y se probó.
GLM-5.3 es el modelo de generación de texto de Z.ai diseñado para flujos de trabajo de codificación agentiva, y Cloudflare lo ofrece en Workers AI.
La filtración se produjo entre el 27 de agosto y el 9 de septiembre de 2026, según el informe de incidentes de Cloudflare del 26 de octubre. Nuestra opinión: la causa no fue el modelo ni un ataque, sino una decisión de configuración combinada con un error en el motor de inferencia. Los pesos del modelo no influyeron en absoluto.
Entonces, ¿qué es exactamente el GLM-5.3?
Z.ai se conocía como Zhipu AI hasta que cambió su marca a nivel internacional en julio de 2025, y la empresa surgió de un grupo de investigación de la Universidad de Tsinghua. La familia GLM se inició en diciembre de 2021 como un proyecto de modelo bilingüe chino-inglés. GLM-5.3 se lanzó el 14 de agosto de 2026, y según la ficha técnica de Z.ai, está basado en el modelo base de GLM-5.2, y todas las mejoras provienen del entrenamiento posterior.
En esencia, se trata de un modelo de «mezcla de expertos», lo que significa que solo una parte de sus parámetros —unos 40 000 millones— se aplica a cada token. Los pesos se publicaron en Hugging Face el 31 de agosto de 2026 bajo una licencia personalizada de Z.ai, en lugar de la licencia MIT.
En Workers AI, Cloudflare ejecuta el modelo en sus propias GPU, por lo que los desarrolladores lo invocan por su nombre en lugar de tener que gestionar el hardware.
¿Qué fue lo que realmente salió mal el 9 de septiembre?
El problema comenzó con una discrepancia que ya se conocía antes del lanzamiento. El modelo se lanzó con una ventana de contexto de 1.048.576 tokens, pero la caché de sus GPU de precarga solo tenía capacidad para 681.280. El equipo lo sabía y lo consideró inofensivo, ya que sus pruebas con contextos largos arrojaban respuestas satisfactorias.
Entonces, el error del motor convirtió esa brecha en una vulnerabilidad. En el modo desagregado de SGLang, las solicitudes que superaban la longitud máxima se marcaban como rechazadas, se sustituían por un marcador de posición de un token y se transmitían, y el decodificador leía páginas de caché obsoletas de solicitudes anteriores. Los clientes recibían un código HTTP 200 en lugar de un error. Otro usuario ya había señalado públicamente el fallo el 6 de julio de 2026, por lo que la advertencia existía mucho antes de que se detectara la fuga. Por eso, un código de estado verde no es prueba de que la respuesta sea correcta.
En cuanto un investigador señaló la filtración, la respuesta se produjo en tan solo un día. El investigador de seguridad Gadi Evron, de Knostic, la notificó a través de HackerOne el 8 de septiembre de 2026. La verificación comenzó a las 08:00 UTC del día siguiente, y se declaró un incidente a las 13:22, tras reproducirse la fuga con dos cuentas. El modelo pasó a ser privado a las 14:00 y volvió a estar disponible a las 19:40 UTC. La solución fue rápida una vez que alguien informó del problema, pero la fuga en sí pasó desapercibida durante unas dos semanas.
La duración de la interrupción del servicio del modelo depende de quién la calcule. Algunas estimaciones sitúan el periodo de inactividad en unas 20 horas, pero ese cómputo se inicia a partir del momento del informe, mientras que son los propios registros de Cloudflare los que miden la interrupción. La solución se probó con la propia reproducción del investigador y con sus pruebas de marcador canario antes de que el modelo volviera a funcionar esa misma tarde, y se informó al proyecto SGLang ese mismo día.
En cifras
- 155: respuestas confirmadas como afectadas, todas a indicaciones de más de 681 280 tokens
- 1 048 576: tokens en la ventana de contexto del GLM-5.3
- 128K: número máximo de tokens generados
- 2,04 millones: número de tokens que contiene actualmente el fondo de preasignación
- De las 14:00 a las 19:40 UTC: tiempo en el que el modelo estuvo fuera de servicio el 9 de septiembre de 2026
- 1: modelo afectado, ya que otras implementaciones cuentan con grupos de caché más grandes
¿Por qué está saliendo todo esto a la luz ahora?
La noticia completa llegó tarde. El informe se publicó unas siete semanas después de que se solucionara el problema. Esto se produjo una vez que había pasado el revuelo inicial por el lanzamiento del modelo y tras una evaluación de seguridad realizada por CAISI, que forma parte del organismo estadounidense de normalización NIST. Habrá más información, ya que el propio informe del investigador sobre el descubrimiento y la validación se publicará más adelante.
CAISI ha determinado que el GLM-5.3 es el modelo de peso abierto con mayor capacidad cibernética lanzado hasta la fecha, aunque sus habilidades cibernéticas se sitúan muy por debajo de los modelos de vanguardia actuales de EE. UU. Su estimación apunta a un retraso de unos cuatro meses, y ha valorado el GLM-5.3 por encima del Kimi K3. Esa valoración es uno de los motivos por los que la noticia se publicó en ese momento.
El debate se dividió según las líneas habituales. Greg Brockman, de OpenAI, advirtió de que el modelo de peso abierto probablemente acelerará el panorama de amenazas, mientras que el exanalista del Departamento de Defensa Jake Williams argumentó que los atacantes ya disponen de herramientas comparables. Ambos bandos parecen exaltados, ya que el propio veredicto de CAISI se sitúa entre ambos. Para ti, esto significa elegir un modelo en función de su rendimiento y de cómo se implementa, y no por el titular de seguridad que más llame la atención.
¿Es bueno y es barato?
Las cifras más llamativas son las de la propia Z.ai. [7] En la ficha técnica de su modelo se afirma que ha mejorado un 50 % en su prueba interna «Code Bench», aunque el propio laboratorio señala que Fable 5 sigue a la cabeza. Las puntuaciones independientes son más modestas, por lo que es mejor fiarse de las pruebas externas que de la página de presentación.
Frente a Kimi K3, su rival más cercano, el resultado es prácticamente un empate. Kimi K3 gana en 5 de las 9 pruebas comparativas compartidas y, además, admite imágenes, algo que GLM-5.3 no hace. La ventana de contexto es idéntica, y Kimi K3 tiene muchos más parámetros.
El precio es donde GLM-5.3 se sitúa a la cabeza. El precio de catálogo de Z.ai es de 1,40 dólares por millón de tokens de entrada, y el modelo resulta aproximadamente 3,0 veces más barato por token que Kimi K3. Sin embargo, los precios de catálogo subestiman las ejecuciones prolongadas de los agentes, ya que una tarea que requiere el máximo esfuerzo cuesta más que una que requiere poco esfuerzo.
Hay un aspecto importante que hay que tener en cuenta: los datos no incluyen el precio de Workers AI para GLM-5.3, y la página de comparación ni siquiera menciona a Workers AI. Es probable que la ventaja en cuanto al coste sea real con los precios de Z.ai, pero no está demostrada en el caso de Workers AI.
Qué implica desarrollar aplicaciones con Workers AI
En nuestra opinión, GLM-5.3 es adecuado para equipos que desarrollan agentes de programación o flujos de trabajo de revisión de código y que buscan un modelo abierto y potente sin tener que gestionar GPU. El autoalojamiento es la alternativa, y requiere al menos 8 GPU de clase H200 o superior, por lo que solo tiene sentido si se desea tener control sobre el propio hardware. No resulta tan adecuado para datos confidenciales con longitudes de contexto extremas, para equipos que necesitan visión artificial o para compradores con restricciones de adquisición de proveedores de la República Popular China.
Hay algunos hábitos que pueden resultar útiles. Envía un encabezado «x-session-affinity» para las sesiones de agente, limita la longitud de las indicaciones en tu propia pasarela y comprueba el contenido de la respuesta, en lugar de limitarte a los códigos de estado. El informe de incidencias es el lugar adecuado para comprobar si tu cuenta se encontraba entre las solicitudes afectadas.
La capacidad sin servidor es compartida y no existe una garantía estricta de procesamiento. Esto es importante porque la API asíncrona es la vía recomendada para flujos de trabajo duraderos, por lo que los equipos con tareas de larga duración deberían empezar por ahí. Antes de adoptarla, consulta la página actual de precios de Workers AI y compara el rendimiento del modelo con tus propias tareas.
Hacia dónde se dirige esto
Consideramos que el GLM-5.3 es un modelo de codificación fiable y de bajo coste, aunque un paso por detrás de los modelos de frontera cerrada. El número de respuestas afectadas indica un daño limitado, aunque esto no significa que se haya descartado la existencia de daño.
El escenario base es un crecimiento constante entre los agentes de codificación sensibles a los costes, siempre y cuando se mantengan el mayor tamaño del grupo de caché y la corrección de SGLang v0.5.22. El riesgo es que nuevos detalles minen la confianza y que las empresas más cautelosas se decanten por modelos cerrados u otros modelos alojados. Hay que estar atentos a cualquier revisión del número de sistemas afectados y a los cambios en la forma de probar el modelo.
En cuanto a las prestaciones, es posible que se produzca otro lanzamiento rápido de Z.ai, y el retraso de cuatro meses de CAISI es solo una instantánea. La licencia personalizada y el lanzamiento por fases podrían determinar quién lo adopta. Lo que debes comprobar a continuación: el precio publicado de Workers AI, el informe del investigador y los nuevos resultados de CAISI.
Fuentes 12unite.ai, BigGo Finance, Cloudflare y 9 fuentes más
- unite.ai (Oct 26, 2026). Cloudflare Says GLM-5.3 Bug Leaked 155 Responses Across Tenant Sessions. Miles Okada
- BigGo Finance (Oct 27, 2026). Cloudflare Confirms AI Platform Data Leak: 155 Responses Mixed With Other Users' Requests, Ultra-Long Contexts Blamed — BigGo Finance. BigGo Finance
- Cloudflare (Oct 26, 2026). Cross-request KV cache exposure in the GLM-5.3 Workers AI model (155 responses)
- LLMLearner (Sep 5, 2026). GLM-5.3 Benchmark Results Analysis & Model Comparisons
- explainx.ai (Jun 29, 2026). GLM-5.3 Vision: Zhipu Community Wishlist Explained. Yash Thakker
- Turing Post (May 4, 2024). Zhipu AI (Z.ai): Founders, GLM Models, and Hong Kong IPO. Ksenia Se
- Tech AI Wire (Aug 31, 2026). GLM-5.3 weights ship under a custom license and need eight .... Tech AI Wire Team
- NIST (Sep 17, 2026). CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities
- lmsys.org (Oct 26, 2026). SGLang security update: improving request isolation - LMSYS Org
- Emergent (Aug 20, 2026). GLM 5.3 Review: What the AI Community Is Actually Saying
- LLM Stats (Aug 14, 2026). GLM-5.3 vs Kimi K3: Benchmarks, Pricing & Which Is Better in 2026. LLM Stats
- Cloudflare (Mar 19, 2026). Powering the agents: Workers AI now runs large models, starting with Kimi K2.5. Michelle Chen
Última actualización: 27 oct 2026. Este artículo se basa en información y datos de estas fuentes; los enlaces del texto llevan a las más importantes.
Comentarios
Todavía no hay comentarios. Sé el primero en decir qué te parece este artículo.