Le lancement du GLM-5.3 de Cloudflare a mal tourné, mais le modèle n'était pas en cause
GLM-5.3 est un modèle de codage performant et abordable proposé par Z.ai. Ses premières semaines sur la plateforme Workers AI de Cloudflare ont été marquées par une fuite due à un problème de déploiement et de test. Voici ce qui s'est passé et comment y remédier.
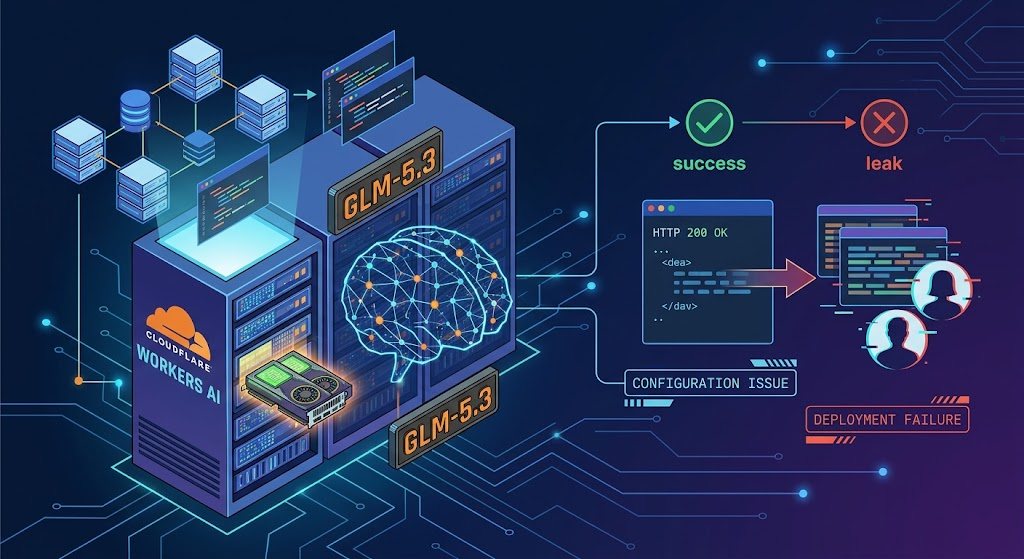
Tout développeur connaît ce petit frisson que procure une coche verte à laquelle on ne peut pas tout à fait se fier. Pendant environ deux semaines, un code de réussite a masqué un problème : 155 réponses à des requêtes particulièrement longues contenaient des fragments de sessions d’autres clients. Cette histoire ne porte pas sur un modèle défectueux, mais sur la manière dont il a été lancé et testé.
GLM-5.3 est le modèle de génération de texte de Z.ai conçu pour les workflows de codage agentique, et Cloudflare le propose sur Workers AI.
Selon le rapport d'incident de Cloudflare daté du 26 octobre, la fuite s'est produite du 27 août au 9 septembre 2026. Notre analyse : la cause n'était ni le modèle ni une attaque, mais un choix de configuration associé à un bug dans le moteur d'inférence. Les poids du modèle n'ont joué aucun rôle.
Mais qu'est-ce que le GLM-5.3 exactement ?
Z.ai était connue sous le nom de Zhipu AI jusqu’à son changement de nom à l’international en juillet 2025 ; l’entreprise est issue d’un groupe de recherche de l’université de Tsinghua. La famille GLM a vu le jour en décembre 2021 sous la forme d’un projet de modèle bilingue chinois-anglais. GLM-5.3 a été lancé le 14 août 2026, et la fiche technique de Z.ai indique qu’il s’appuie sur le modèle de base de GLM-5.2, toutes ses améliorations provenant d’un entraînement postérieur.
En réalité, il s’agit d’un modèle de type « mixture-of-experts », ce qui signifie que seule une partie de ses paramètres, soit environ 40 milliards, est utilisée pour chaque token. Les poids ont été mis à disposition sur Hugging Face le 31 août 2026 sous une licence Z.ai personnalisée, et non sous la licence MIT.
Sur Workers AI, Cloudflare exécute le modèle sur ses propres GPU ; les développeurs peuvent ainsi l'appeler directement par son nom, sans avoir à gérer le matériel.
Que s'est-il réellement passé le 9 septembre ?
Le problème a commencé par une incompatibilité connue avant le lancement. Le modèle a été lancé avec une fenêtre de contexte de 1 048 576 tokens, mais le cache de ses GPU de préremplissage ne pouvait en contenir que 681 280. L'équipe en avait connaissance et avait jugé cela sans conséquence, car ses tests sur des contextes longs avaient donné des résultats positifs.
Puis, un bug du moteur a transformé cette faille en une vulnérabilité. En mode désagrégé de SGLang, les requêtes trop longues étaient marquées comme rejetées, remplacées par un espace réservé d’un seul token puis transmises, et le décodeur lisait des pages de cache obsolètes provenant de requêtes antérieures. Les clients recevaient un code HTTP 200 au lieu d’une erreur. Un autre utilisateur avait signalé publiquement cette faille le 6 juillet 2026 ; l’avertissement existait donc bien avant que la fuite ne soit détectée. C’est pourquoi un code d’état vert ne constitue pas une garantie de réponse valide.
Dès qu'un chercheur a signalé la fuite, la réponse n'a pris qu'une seule journée. Le chercheur en sécurité Gadi Evron, de Knostic, l'a signalée via HackerOne le 8 septembre 2026. La vérification a débuté à 08 h 00 UTC le lendemain, et un incident a été déclaré à 13 h 22 après que la fuite eut été reproduite avec deux comptes. Le modèle a été mis en mode privé à 14 h 00 et est redevenu accessible à 19 h 40 UTC. La correction a été rapide une fois le problème signalé, mais la fuite elle-même est passée inaperçue pendant environ deux semaines.
La durée de l'indisponibilité du modèle dépend de la source. Certaines estimations évaluent la période d'indisponibilité à environ 20 heures, mais ce décompte commence à partir du moment où le rapport a été publié, alors que ce sont les mesures de Cloudflare qui déterminent la durée réelle de la panne. La correction a été testée par rapport à la reproduction effectuée par le chercheur lui-même et à ses tests « canary-marker » avant que le modèle ne soit rétabli dans la soirée, et le projet SGLang en a été informé le jour même.
En chiffres
- 155 : réponses confirmées comme concernées, toutes en réponse à des invites de plus de 681 280 tokens
- 1 048 576 : nombre de tokens dans la fenêtre de contexte du GLM-5.3
- 128K : nombre maximal de jetons
- 2,04 millions : nombre de jetons que contient actuellement le pool de préremplissage
- De 14 h 00 à 19 h 40 UTC : période d'indisponibilité du modèle le 9 septembre 2026
- 1 : modèle concerné, car d'autres déploiements disposent de pools de cache plus importants
Pourquoi tout cela refait-il surface maintenant ?
Le récit complet a été publié tardivement. Le rapport est paru environ sept semaines après la correction. Il a été publié après le battage médiatique entourant le lancement du modèle et après une évaluation de sécurité réalisée par le CAISI, qui fait partie de l’organisme américain de normalisation NIST. D’autres informations suivront, car le rapport du chercheur lui-même, portant sur la découverte et la validation, doit paraître ultérieurement.
Le CAISI a estimé que le GLM-5.3 était le modèle « open-weight » le plus performant en matière de cybersécurité parmi ceux publiés à ce jour, même si ses capacités dans ce domaine restent nettement inférieures à celles des modèles américains de pointe actuels. Selon ses estimations, il accuse un retard d’environ quatre mois, et le GLM-5.3 a été classé au-dessus du Kimi K3. Cette évaluation explique en partie pourquoi l’article a été publié à ce moment-là.
Le débat s'est divisé selon des lignes de fracture bien connues. Greg Brockman, d'OpenAI, a averti que le modèle à poids ouvert risquait d'accélérer l'évolution des menaces, tandis que Jake Williams, ancien analyste du ministère de la Défense, a fait valoir que les attaquants disposaient déjà d'outils comparables. Les deux camps semblent s'emballer, puisque le verdict de la CAISI se situe entre les deux. Pour vous, cela signifie qu’il faut choisir un modèle en fonction de ses performances et de son mode de déploiement, et non en fonction des gros titres les plus retentissants en matière de sécurité.
Est-ce que c'est un bon produit, et est-ce que c'est pas cher ?
Les chiffres les plus impressionnants sont ceux avancés par Z.ai. La fiche technique de son modèle annonce une amélioration de 50 % par rapport à son benchmark interne « Code Bench », mais le laboratoire lui-même indique que Fable 5 reste en tête. Les résultats des tests indépendants sont plus modestes ; il vaut donc mieux se fier aux tests externes plutôt qu'à la page de lancement.
Face à Kimi K3, son rival le plus proche, les résultats sont pratiquement à égalité. Kimi K3 l’emporte dans 5 des 9 tests comparatifs communs et prend également en charge les images, ce qui n’est pas le cas de GLM-5.3. La fenêtre de contexte est identique, et Kimi K3 dispose d’un nombre de paramètres bien plus important.
C'est sur le plan du prix que le GLM-5.3 prend l'avantage. Le prix catalogue de Z.ai s'élève à 1,40 $ par million de tokens d'entrée, et le modèle revient environ 3,0 fois moins cher par token que le Kimi K3. Les prix catalogue sous-estiment toutefois les exécutions d'agent de longue durée, car une tâche nécessitant un effort maximal coûte plus cher qu'une tâche nécessitant peu d'effort.
Il y a toutefois une lacune importante à signaler : les données disponibles ne mentionnent aucun tarif de Workers AI pour le GLM-5.3, et la page de comparaison ne fait aucune mention de Workers AI. L'avantage en termes de coût est probablement réel aux tarifs de Z.ai, mais n'est pas avéré pour Workers AI.
Ce que cela implique de développer des applications avec Workers AI
Selon nous, GLM-5.3 convient aux équipes qui développent des agents de codage ou des pipelines de révision de code et qui recherchent un modèle ouvert performant sans avoir à gérer de GPU. L’auto-hébergement constitue une alternative, mais il nécessite au moins 8 GPU de classe H200 ou supérieure ; cette option n’est donc pertinente que si vous souhaitez garder le contrôle de votre propre matériel. Il est moins adapté aux données sensibles présentant des longueurs de contexte extrêmes, aux équipes ayant besoin de vision par ordinateur, ou aux acheteurs soumis à des restrictions d’approvisionnement auprès de fournisseurs chinois.
Certaines pratiques peuvent s'avérer utiles. Envoyez un en-tête « x-session-affinity » pour les sessions des agents, limitez la longueur des messages d'invite dans votre propre passerelle et vérifiez le contenu des réponses plutôt que de vous limiter aux codes d'état. Le rapport d'incident vous permettra de vérifier si votre compte figurait parmi les requêtes concernées.
La capacité « serverless » est partagée, et il n’y a pas de garantie stricte en matière de traitement. C’est important, car l’API asynchrone est la solution recommandée pour les workflows durables ; les équipes dont les tâches s’exécutent sur une longue durée devraient donc commencer par là. Avant de l'adopter, consultez la page actuelle des tarifs de Workers AI et évaluez les performances du modèle sur vos propres tâches.
Où cela va-t-il nous mener ?
Nous estimons que le GLM-5.3 est un modèle de codage fiable et peu coûteux, qui se situe toutefois un cran en dessous des modèles à frontière fermée. Le nombre de réponses concernées indique que les effets néfastes sont limités, ce qui ne signifie pas pour autant qu'ils soient exclus.
Le scénario de base table sur une croissance régulière parmi les agents de codage soucieux des coûts, à condition que l'augmentation de la taille du pool de cache et le correctif apporté à SGLang v0.5.22 tiennent la route. Le risque est que de nouveaux détails érodent la confiance et que les entreprises prudentes se tournent vers des modèles fermés ou d’autres modèles hébergés. Surveillez toute révision du nombre de systèmes affectés ainsi que les changements apportés à la manière dont le modèle est testé.
En termes de capacités, une nouvelle version de Z.ai pourrait bientôt voir le jour, et le décalage de quatre mois de CAISI ne constitue qu'un instantané. La licence sur mesure et le déploiement progressif pourraient influencer le choix des utilisateurs. Prochains éléments à vérifier : la publication du prix de Workers AI, le rapport du chercheur et les nouveaux résultats du CAISI.
Sources 12unite.ai, BigGo Finance, Cloudflare et 9 autres sources
- unite.ai (Oct 26, 2026). Cloudflare Says GLM-5.3 Bug Leaked 155 Responses Across Tenant Sessions. Miles Okada
- BigGo Finance (Oct 27, 2026). Cloudflare Confirms AI Platform Data Leak: 155 Responses Mixed With Other Users' Requests, Ultra-Long Contexts Blamed — BigGo Finance. BigGo Finance
- Cloudflare (Oct 26, 2026). Cross-request KV cache exposure in the GLM-5.3 Workers AI model (155 responses)
- LLMLearner (Sep 5, 2026). GLM-5.3 Benchmark Results Analysis & Model Comparisons
- explainx.ai (Jun 29, 2026). GLM-5.3 Vision: Zhipu Community Wishlist Explained. Yash Thakker
- Turing Post (May 4, 2024). Zhipu AI (Z.ai): Founders, GLM Models, and Hong Kong IPO. Ksenia Se
- Tech AI Wire (Aug 31, 2026). GLM-5.3 weights ship under a custom license and need eight .... Tech AI Wire Team
- NIST (Sep 17, 2026). CAISI’s Assessment of Z.ai’s GLM-5.3 Cyber Capabilities
- lmsys.org (Oct 26, 2026). SGLang security update: improving request isolation - LMSYS Org
- Emergent (Aug 20, 2026). GLM 5.3 Review: What the AI Community Is Actually Saying
- LLM Stats (Aug 14, 2026). GLM-5.3 vs Kimi K3: Benchmarks, Pricing & Which Is Better in 2026. LLM Stats
- Cloudflare (Mar 19, 2026). Powering the agents: Workers AI now runs large models, starting with Kimi K2.5. Michelle Chen
Mis à jour le 27 oct. 2026. Cet article s’appuie sur les articles et les données de ces sources ; les liens dans le texte mènent aux plus importantes.
Commentaires
Aucun commentaire pour l’instant. Soyez le premier à donner votre avis sur cet article.