Cookies. Wir zählen Besuche ohne Cookies. Wenn du zustimmst, setzen wir zusätzlich ein Cookie, um zu sehen, wie die Website genutzt wird. Cookie-Richtlinie
Eine KI-App bauen: der Tool-Stack, Schicht für Schicht
9 Phasen, 24 Tools
aktualisiert am
Eine KI-Funktion, die in einer Demo funktioniert, ist nur ein kleiner Teil der Arbeit. Die Demo besteht aus einem Prompt, einem Modell und fünf freundlichen Eingaben. Das Produkt ist dasselbe, aber im Betrieb mit Tausenden unberechenbarer Nutzer, mit deinen eigenen Daten dahinter, einer Rechnung, die mit der Nutzung wächst, und der Notwendigkeit zu merken, wenn die Antworten schlechter werden.
Der Stack hat deshalb mehrere Schichten. Ein Modell, erreichbar über eine API oder selbst gehostet. Prompts, die wie Code versioniert werden. Retrieval und Gedächtnis, damit das Modell aus deinen Inhalten antwortet statt aus Vermutungen. Möglicherweise eine Agentenschleife mit Tools, die es aufrufen darf. Darum herum gewöhnlicher Anwendungscode, dann Tests, Evaluierung und ein Ort für das Deployment.
Coding-Agenten schreiben inzwischen einen großen Teil dieses Anwendungscodes, und App-Builder können aus einer Beschreibung ein funktionierendes Frontend erzeugen. Die technische Urteilskraft nehmen sie nicht ab: welches Modell für die Aufgabe zu akzeptablen Kosten gut genug ist, wie sich Qualität messen lässt, bevor es die Nutzer tun, welche Daten dein System verlassen dürfen und was passiert, wenn das Modell mit voller Überzeugung falschliegt. Modelle und ihre Bedingungen ändern sich zudem oft. Entwirf die App deshalb so, dass sich ein Modell ohne Neuentwicklung austauschen lässt.
Für wen dieser Guide ist Entwickler, technische Gründer und kleine Produktteams, die einem Produkt eine Funktion mit Sprachmodell hinzufügen oder eine neue App darum herum bauen und vor der Wahl eines Stacks eine Übersicht über die Tools suchen.
Ein üblicher erster Durchlauf für einen Prototyp: Modelle an den eigenen Prompts vergleichen, den Code mit einem Agenten schreiben, früh Tracing einschalten, dann deployen. Die Auswahl folgt dieser Reihenfolge, nicht einer Rangliste.
Verbinde das Repository und teile die Vorschau-URL mit fünf Testnutzern.
1
Phase 1: Ein Modell wählen
Du entscheidest, welches Modell oder welche Modelle die App aufruft, und wägst dabei Ausgabequalität bei deiner eigenen Aufgabe, Geschwindigkeit, Kontextgröße, Kosten pro Anfrage, Datenschutzanforderungen und die Frage ab, ob du eine gehostete API oder ein offenes Modell brauchst, das du selbst betreibst.
Was KI hier übernimmt
Denselben Prompt nebeneinander an verschiedene Modelle schicken, Modelle über vertraute API-Formate bereitstellen und offene Modelle auf eigener Hardware ausführen.
Was KI hier nicht kann
Dir sagen, welches Modell zu deiner Aufgabe passt. Öffentliche Ranglisten spiegeln die Stimmen und Prompts anderer wider, der einzig verlässliche Test sind deshalb deine eigenen Beispiele.
Runs open-source models inside secure hardware enclaves and exposes them through an OpenAI-compatible API, for apps that handle sensitive data.
Private KI-Cloud, die Modelle in gesicherten Hardware-Enklaven ausführt, als Chat-App, Inferenz-API und Container.
Tool ansehen
2
Phase 2: Prompts entwickeln und prototypen
Bevor du Anwendungscode schreibst, arbeitest du die Anweisungen aus: System-Prompt, Beispiele, Ausgabeformat. Du probierst sie an echten Eingaben aus, auch an sperrigen, und behältst jede Version, damit sich Änderungen vergleichen lassen.
Was KI hier übernimmt
Eine grobe Anfrage in einen strukturierten Prompt umschreiben, Schwächen eines bestehenden Prompts analysieren und eine versionierte Prompt-Bibliothek führen.
Was KI hier nicht kann
Deine Sonderfälle kennen. Ein Prompt, der gut klingt, kann bei den Eingaben scheitern, die deine Nutzer tatsächlich schicken, und das zeigt nur ein Test mit gesammelten Beispielen.
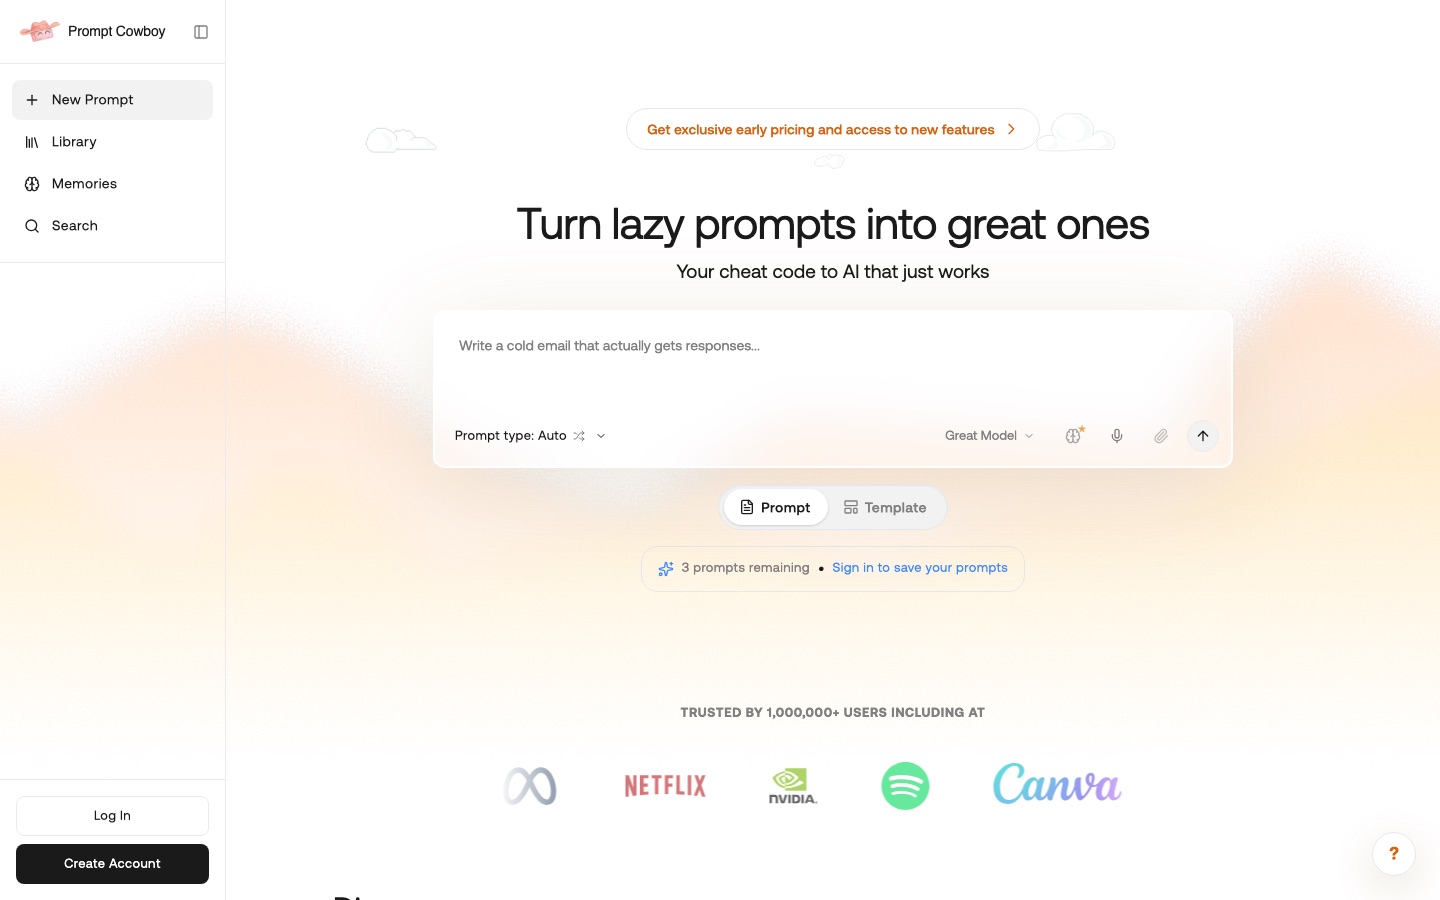
Macht aus einer kurzen, groben Anfrage einen klaren, strukturierten Prompt und speichert jeden Prompt in einer durchsuchbaren Bibliothek zur Wiederverwendung.
Prompt-Generator, der aus einer groben Anfrage einen strukturierten Prompt für ChatGPT, Claude, Gemini und andere Modelle macht.
Analyzes a prompt for strengths and weaknesses, rewrites it in rounds and records each version so earlier ones can be recovered.
Prompt-Workspace zum Erzeugen, Analysieren, Optimieren und Rückwärtsentwickeln von Prompts für Text-, Bild- und Videomodelle.
Tool ansehen
3
Phase 3: Modell-APIs, Gateways und Inferenz-Hosting
Du bindest die App so an Modelle an, dass sie im Produktivbetrieb besteht: Schlüssel bleiben auf dem Server, Wiederholungen und Ausweichmodelle greifen, wenn ein Anbieter ausfällt, dazu Ratenlimits, Kostenverfolgung und GPU-Hosting, falls du ein offenes Modell selbst bereitstellst.
Was KI hier übernimmt
Anfragen über einen Endpunkt mit Fallback und Kontingenten an viele Modelle leiten und offene Modelle auf automatisch skalierender GPU-Infrastruktur bereitstellen, ohne Cluster zu verwalten.
Was KI hier nicht kann
Die Abhängigkeit von Anbietern beseitigen. Preise, Ratenlimits und Modellversionen ändern sich nach deren Zeitplan, also lege Versionen fest und lies die Bedingungen zur Datennutzung.
Documents how to call its models from application code and coding agents, with thinking mode that can be switched off per request.
KI-Forschungsunternehmen mit Chat-Assistent, Desktop-Harness und einer nach Tokens abgerechneten API für seine Sprachmodelle.
Tool ansehen
4
Phase 4: Retrieval, Gedächtnis und Daten
Die meisten nützlichen Apps antworten aus bestimmten Inhalten: deiner Dokumentation, den Dateien eines Kunden, dem Live-Web, früheren Gesprächen. Du liest diese Inhalte ein und indizierst sie, rufst pro Anfrage die passenden Teile ab und gibst sie mit Quellen an das Modell weiter.
Was KI hier übernimmt
Webseiten als sauberes Markdown abrufen, Embeddings speichern und durchsuchen, relevante Abschnitte mit Quellenlinks zurückgeben und ein Gedächtnis pro Nutzer über Sitzungen hinweg führen.
Was KI hier nicht kann
Schlechtes Quellmaterial reparieren. Retrieval liefert, was im Index liegt, und veraltete oder widersprüchliche Dokumente führen zu veralteten oder widersprüchlichen Antworten.
Builds a per-user graph of dated facts from data and conversations and returns the context a task needs in one call.
Kontext- und Gedächtnisebene für KI-Agenten, die aus Unternehmensdaten, Dokumenten und Gesprächen kontrollierte Wissensgraphen aufbaut.
Tool ansehen
5
Phase 5: Agenten-Frameworks und Tool-Zugriff
Soll die App nicht nur antworten, sondern handeln, baust du eine Agentenschleife: Das Modell entscheidet, welches Tool es aufruft, dein Code führt es aus und gibt das Ergebnis zurück. Du legst fest, welche Tools es gibt, welche Berechtigungen sie haben und wann ein Mensch bestätigen muss.
Was KI hier übernimmt
Bibliotheken zum Schreiben von Agenten mit jedem Modellanbieter bereitstellen, Tool-Schemas aus gewöhnlichen Funktionen erzeugen und die Authentifizierung bei Tool-Servern von Drittanbietern verwalten.
Was KI hier nicht kann
Einen Agenten von sich aus sicher machen. Jedes Tool, das du bereitstellst, kann das Modell im falschen Moment aufrufen, also begrenze Berechtigungen eng und lass nicht umkehrbare Aktionen bestätigen.
Verbindet einen Agenten mit MCP-Servern aus einem Katalog und verwaltet OAuth, Zugangsdaten und Sitzungen für diese Verbindungen.
Registry und Verbindungsschicht, die KI-Agenten mit MCP-Servern verknüpft und OAuth sowie Zugangsdaten verwaltet.
Tool ansehen
6
Phase 6: Den Code schreiben
Um das Modell herum steht eine normale Anwendung: API-Routen, Datenmodelle, Authentifizierung, Hintergrundjobs, eine Benutzeroberfläche. Du schreibst, prüfst und testest diesen Code, zunehmend indem du Aufgaben an einen Coding-Agenten delegierst und seine Änderungen durchsiehst.
Was KI hier übernimmt
Eine Codebasis erkunden, eine Änderung planen, Dateien bearbeiten, Tests ausführen und aus einer Aufgabe in normaler Sprache einen Pull Request öffnen sowie Pull Requests Zeile für Zeile prüfen.
Was KI hier nicht kann
Die Architektur oder die Folgen verantworten. Generierter Code kann seine Tests bestehen und trotzdem unsicher oder für deine Anforderungen falsch sein, deshalb muss ein Entwickler lesen, was gemergt wird.
Nimmt eine schriftliche Entwicklungsaufgabe entgegen, erkundet die Codebasis, schlägt einen Plan vor und nimmt die Änderungen vor, die du annehmen oder überarbeiten kannst.
KI-Coding-Agent und Editor, der Code auf dem Desktop, im Terminal und in der Cloud plant, schreibt und prüft.
Plant Programmieraufgaben, bearbeitet Dateien, führt Tests aus und öffnet Pull Requests in deinem Repository, wobei es nachfragt, bevor es Dateien ändert oder Befehle ausführt.
Der KI-Coding-Agent von Anthropic plant, bearbeitet Code, führt Tests aus und öffnet Pull Requests, direkt aus dem Terminal oder der IDE.
Prüft jeden Pull Request mit Kommentaren auf Zeilenebene und übernehmbaren Vorschlägen, was hilft, wenn ein großer Teil des Codes von Agenten stammt.
KI-Code-Review, das jeden Pull Request kommentiert, mit PR-Triage, Erklärungen zu Änderungen und Sicherheitsüberwachung.
Tool ansehen
7
Phase 7: Sprach-, Bild- und Videofunktionen
Manche Apps brauchen mehr als Text: gesprochene Antworten, Transkription, Sprachgespräche in Echtzeit, generierte Bilder oder Clips. Das sind eigene Modelle mit eigenen APIs, Latenzbudgets und Nutzungsregeln.
Was KI hier übernimmt
Text-zu-Sprache, Sprache-zu-Text und Sprachgespräche im Vollduplex über eine API hinzufügen und Videos oder Bilder aus dem Anwendungscode erzeugen.
Was KI hier nicht kann
Die Rechte für dich klären. Die Stimme einer echten Person zu klonen setzt ihre Einwilligung voraus, und die kommerzielle Nutzung generierter Medien hängt von den Bedingungen des Anbieters und deinem Tarif ab.
Stellt seine Modelle zur Video- und Bildgenerierung über eine Entwickler-API mit Dokumentation und einem Modell-Router bereit.
KI-Plattform zum Erzeugen und Bearbeiten von Video, Bild und Audio, mit Entwickler-API und Weltmodellen.
Tool ansehen
8
Phase 8: Evaluierung und Monitoring
Du baust aus echten Eingaben einen Testsatz auf, bewertest die Ausgaben vor jeder Änderung und verfolgst nach dem Launch jede Anfrage, damit Fehler, Kosten und Latenz sichtbar sind. Menschliche Durchsicht deckt ab, was automatische Bewertung nicht beurteilen kann.
Was KI hier übernimmt
Jeden Schritt eines Laufs aufzeichnen, Datensätze aus echten Traces aufbauen, automatische Prüfer für Probleme wie Halluzinationen laufen lassen und Ausgaben für die menschliche Bewertung in eine Warteschlange stellen.
Was KI hier nicht kann
Festlegen, was für dein Produkt eine gute Antwort ist. Jemand muss die Kriterien schreiben und Beispiele beschriften, und automatische Prüfer sind selbst Modelle, die Fehler machen.
Die Plattform LangSmith zeichnet jeden Schritt eines Agentenlaufs auf, baut Datensätze aus echten Traces auf und führt Online- und Offline-Evaluierungen durch.
Open-Source-Frameworks für Agenten plus die Plattform LangSmith zum Nachverfolgen, Bewerten und Bereitstellen von KI-Agenten.
Schickt KI-Prüfer gegen Chat- und Sprachagenten, um vor dem Release auf Halluzinationen, Voreingenommenheit, Toxizität und Compliance-Probleme zu testen.
Cloud fürs Testen von Software, früher LambdaTest, mit KI-Agenten, die Tests für Web-, Mobil- und KI-Apps planen, schreiben und ausführen.
Die KI-Observability verfolgt die Ereignisse, die die Modellaufrufe einer Anwendung erzeugen, neben Sitzungswiedergaben und Fehlerverfolgung für den Rest der App.
Produktdatenplattform, die Analysen, Session Replay, Feature Flags, Fehlerverfolgung und ein Data Warehouse vereint, mit KI obendrauf.
Tool ansehen
9
Phase 9: Die App ausliefern
Die App braucht ein Frontend, Benutzerkonten, Hosting, eine Domain und einen Release-Prozess mit Vorschauen und Rollback. Bei einem Prototyp oder internen Tool lässt sich das generieren, bei einem Produkt ist es bewusste Ingenieursarbeit.
Was KI hier übernimmt
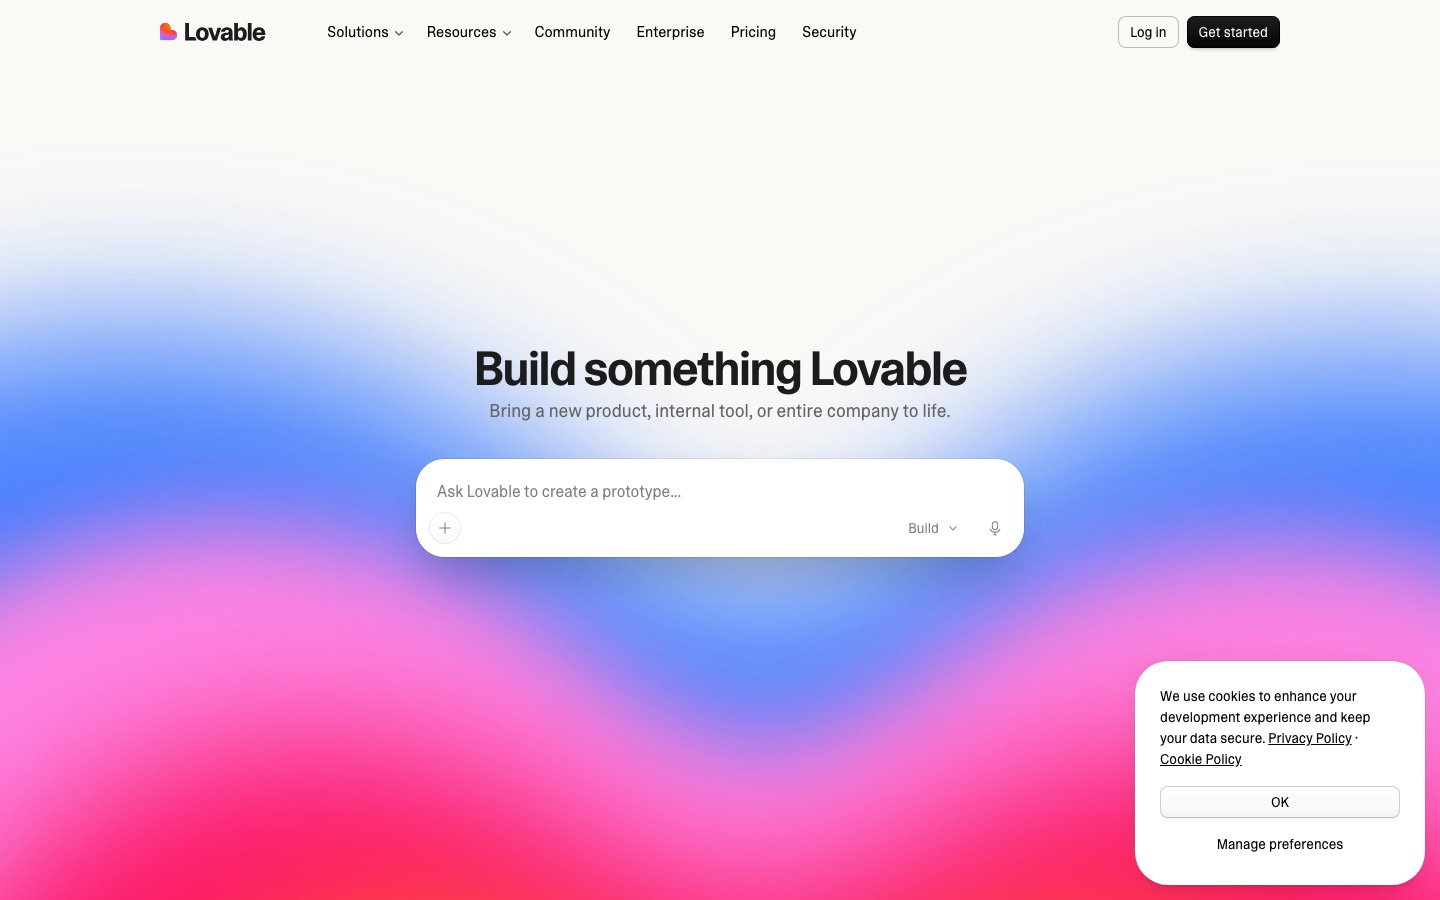
Aus einer Beschreibung eine funktionierende Web-App mit Oberfläche, Logik und Datenschicht erzeugen, bei jedem Code-Push deployen und jeder Änderung eine Vorschauadresse geben.
Was KI hier nicht kann
Dir abnehmen, was nach dem Launch kommt: Missbrauch, Ratenbegrenzung, Datenschutzanfragen, Support und eine Nutzungsrechnung, die mit jedem Nutzer wächst.
Übernimmt Registrierungen und Logins und stellt Datenbanktabellen über REST-Endpunkte bereit, sodass die App ohne eigenen Servercode ein Backend hat.
Postgres-Entwicklungsplattform mit Authentifizierung, sofort nutzbaren APIs, Edge Functions, Realtime, Speicher und Vektor-Embeddings.
Ab 25 $/MonatTool ansehen
Realistische Erwartungen
Modelle liegen mit Überzeugung falsch
Ein Sprachmodell kann eine flüssige Antwort liefern, die falsch ist, und Retrieval verringert das, ohne es zu beseitigen. Zeige Quellen, wo du kannst, teste mit echten Eingaben und lass keine ungeprüfte Ausgabe Entscheidungen über Gesundheit, Geld oder rechtliche Fragen steuern.
Nutzerdaten und Bedingungen der Anbieter
Jeder Prompt, den du sendest, kann personenbezogene oder vertrauliche Daten enthalten. Prüfe die Bedingungen jedes Anbieters zu Aufbewahrung und Training, sage den Nutzern, was verarbeitet wird, und erwäge für sensible Workloads selbst gehostete oder Enclave-basierte Inferenz.
Die Kosten wachsen mit der Nutzung
Tokens, Credits, GPU-Sekunden und Tool-Aufrufe werden alle abgerechnet. Eine Funktion, die im Test wenig kostet, kann mit langen Kontexten oder Agentenschleifen teuer werden. Setze deshalb Ausgabenlimits und miss die Kosten pro Anfrage.
Generierter Code braucht weiterhin ein Review
Coding-Agenten und App-Builder erzeugen schnell funktionierende Software, auch solche mit Sicherheitslücken. Prüfe Authentifizierung, Regeln für den Datenzugriff und den Umgang mit Geheimnissen selbst, bevor echte Nutzer kommen.
Prompt Injection ist ein echter Angriff
Text, den das Modell von Webseiten, aus Dokumenten oder von Nutzern liest, kann Anweisungen enthalten. Behandle die Ausgabe des Modells als nicht vertrauenswürdig, beschränke die Tools, die ein Agent aufrufen darf, und verlange eine Bestätigung für alles, was sich nicht rückgängig machen lässt.
Häufige Fragen
Sollte ich eine gehostete Modell-API aufrufen oder ein offenes Modell selbst betreiben?
Beginne mit einer gehosteten API, solange du keinen klaren Grund dagegen hast. Darauf baut man schneller auf, und es braucht keinen GPU-Betrieb. Ein offenes Modell selbst zu betreiben ist sinnvoll, wenn Daten in deiner Umgebung bleiben müssen, wenn du Fine-Tuning brauchst oder wenn das Volumen so hoch ist, dass eigene Rechenleistung günstiger ist. Viele Teams bauen den Prototyp auf einer API und überdenken die Wahl, sobald die Nutzung bekannt ist.
Brauche ich ein Agenten-Framework, um eine KI-App zu bauen?
Oft nicht. Ein einzelner Modellaufruf mit guten Anweisungen und abgerufenem Kontext deckt viele Funktionen ab: zusammenfassen, klassifizieren, extrahieren, aus Dokumenten antworten. Ein Framework lohnt sich, wenn das Modell zwischen Tools wählen, mehrere Schritte ausführen, einen Zustand halten oder sich von Fehlern erholen muss. Wer eines früh einsetzt, bekommt auch mehr Konzepte zum Debuggen. Beginne also einfach und nimm es hinzu, wenn der schlichte Ansatz nicht mehr genügt.
Kann jemand ohne Entwicklerkenntnisse mit diesen Tools eine KI-App bauen?
Einen Prototyp oder ein internes Tool, ja. Die App-Builder in diesem Guide erzeugen aus einer Beschreibung eine funktionierende Web-App mit Login und Hosting. Ein Produkt, das Kundendaten und Zahlungen verarbeitet, ist etwas anderes: Jemand muss Sicherheit, Kosten und Fehlerbehandlung verstehen. Ein sinnvoller Weg ist, ohne Code einen Prototyp zu bauen, mit echten Nutzern zu testen und vor dem Skalieren einen Entwickler dazuzuholen.
Woran erkenne ich, ob meine KI-Funktion gut genug für den Launch ist?
Sammle echte Eingaben, schreibe für jede auf, wie eine richtige Antwort aussieht, und bewerte das System vor jeder Änderung daran. Nimm schwierige und gezielt provokante Fälle auf. Verbinde automatische Prüfungen mit menschlicher Durchsicht einer Stichprobe. Starte mit einer kleinen Gruppe und eingeschaltetem Tracing, lies die Fehlschläge und weite den Zugang aus, sobald die Fehlerquote für deinen Einsatz vertretbar ist.

 Modal

 Zep

 Firecrawl

 Vercel

 Supabase
 Prompt Cowboy
 Lovable

 LangChain
 v0