Een AI-functie die in een demo werkt, is maar een klein deel van het werk. De demo is één prompt, één model en vijf vriendelijke invoeren. Het product is hetzelfde, maar dan tegenover duizenden onvoorspelbare gebruikers, met je eigen data erachter, een rekening die met het gebruik meegroeit en de behoefte om te weten wanneer antwoorden slechter worden.
De stack heeft dus lagen. Een model, bereikbaar via een API of zelf gehost. Prompts waarvan je versies bijhoudt zoals bij code. Retrieval en geheugen, zodat het model antwoordt vanuit jouw content in plaats van te gokken. Eventueel een agentlus met tools die het mag aanroepen. Gewone applicatiecode eromheen, en dan tests, evaluatie en een plek om uit te rollen.
Codeeragenten schrijven nu een groot deel van die applicatiecode, en appbuilders kunnen uit een beschrijving een werkende front-end maken. Wat ze niet beslechten, is het technische oordeel: welk model goed genoeg is voor de taak tegen aanvaardbare kosten, hoe je de kwaliteit meet voordat gebruikers het doen, welke data je systeem mag verlaten en wat er gebeurt als het model stellig ongelijk heeft. Modellen en hun voorwaarden veranderen ook vaak, dus ontwerp de app zo dat je een model kunt verwisselen zonder alles te herschrijven.
Voor wie deze gids is Ontwikkelaars, technische oprichters en kleine productteams die een functie met een taalmodel aan een product toevoegen of er een nieuwe app omheen bouwen en een overzicht van de tooling willen voordat ze een stack kiezen.
Een gangbare eerste ronde voor een prototype: modellen vergelijken op je eigen prompts, de code met een agent schrijven, vroeg tracing toevoegen en dan uitrollen. De keuzes volgen die volgorde, geen ranglijst.
Koppel de repository en deel de preview-URL met vijf testgebruikers.
1
Fase 1: Een model kiezen
Je bepaalt welk model of welke modellen de app aanroept, en weegt daarbij de kwaliteit van de uitvoer op je eigen taak, snelheid, contextgrootte, kosten per verzoek, privacyvereisten en of je een gehoste API wilt of een open model dat je zelf draait.
Wat AI hier doet
Dezelfde prompt naast elkaar naar verschillende modellen sturen, modellen beschikbaar maken via vertrouwde API-formaten en open modellen op je eigen hardware draaien.
Wat AI hier niet kan
Zeggen welk model bij jouw taak past. Openbare ranglijsten weerspiegelen de stemmen en prompts van anderen, dus de enige betrouwbare test zijn je eigen voorbeelden.
Runs open-source models inside secure hardware enclaves and exposes them through an OpenAI-compatible API, for apps that handle sensitive data.
Private AI-cloud die modellen binnen beveiligde hardware-enclaves draait, aangeboden als chatapp, inference-API en containers.
Tool bekijken
2
Fase 2: Prompten en prototypen
Voordat je applicatiecode schrijft, werk je de instructies uit: systeemprompt, voorbeelden, uitvoerformaat. Je probeert ze uit op echte invoer, ook lastige, en bewaart elke versie, zodat je wijzigingen kunt vergelijken.
Wat AI hier doet
Een ruw verzoek herschrijven tot een gestructureerde prompt, analyseren wat er zwak is aan een bestaande prompt en een bibliotheek van prompts met versiebeheer bijhouden.
Wat AI hier niet kan
Je randgevallen kennen. Een prompt die goed leest, kan nog steeds falen op de invoer die je gebruikers echt sturen, en dat blijkt alleen uit testen op verzamelde voorbeelden.
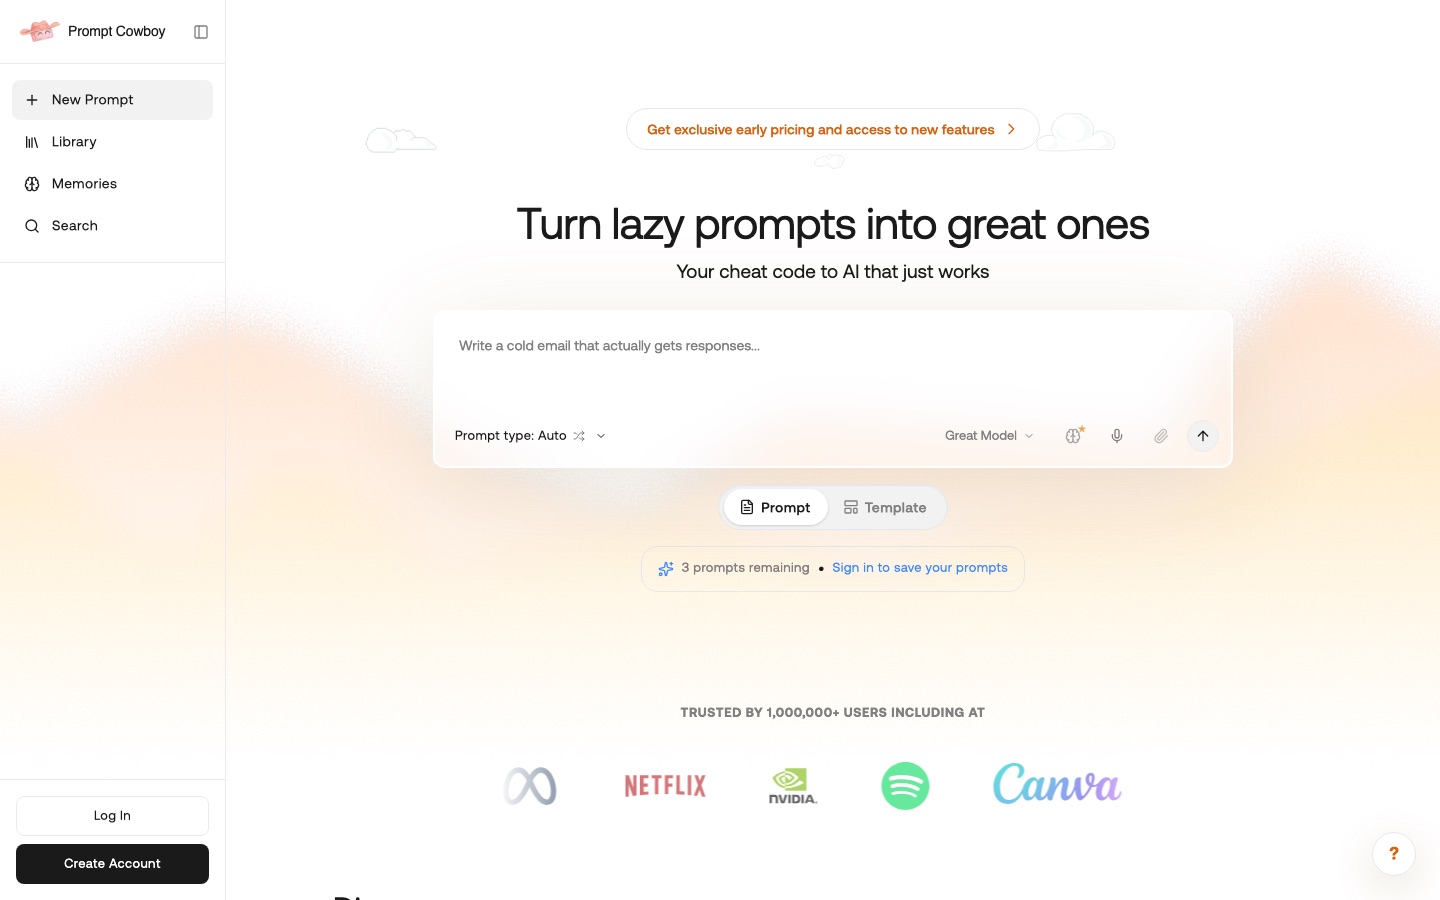
Analyzes a prompt for strengths and weaknesses, rewrites it in rounds and records each version so earlier ones can be recovered.
Promptwerkomgeving om prompts voor tekst-, beeld- en videomodellen te genereren, analyseren, optimaliseren en terug te herleiden.
Tool bekijken
3
Fase 3: Model-API’s, gateways en inferentiehosting
Je koppelt de app zo aan modellen dat hij productie overleeft: sleutels die server-side blijven, nieuwe pogingen en terugvalopties als een aanbieder uitvalt, ratelimieten, bijhouden van uitgaven en GPU-hosting als je een open model zelf serveert.
Wat AI hier doet
Verzoeken via één endpoint naar veel modellen sturen met terugval en quota, en open modellen serveren op automatisch schalende GPU-infrastructuur zonder clusters te beheren.
Wat AI hier niet kan
De afhankelijkheid van aanbieders opheffen. Prijzen, ratelimieten en modelversies veranderen volgens hun planning, dus zet versies vast en lees de voorwaarden voor datagebruik.
Documents how to call its models from application code and coding agents, with thinking mode that can be switched off per request.
AI-onderzoeksbedrijf met een chatassistent, een desktop-harness en een API met tokenfacturering voor zijn taalmodellen.
Tool bekijken
4
Fase 4: Retrieval, geheugen en data
De meeste nuttige apps antwoorden vanuit specifieke content: je documentatie, de bestanden van een klant, het live web, eerdere gesprekken. Je neemt die content op en indexeert haar, haalt per verzoek de relevante stukken op en geeft ze met bronnen aan het model.
Wat AI hier doet
Webpagina’s als schone Markdown ophalen, embeddings opslaan en doorzoeken, relevante fragmenten met bronlinks teruggeven en per gebruiker geheugen bijhouden over sessies heen.
Wat AI hier niet kan
Slecht bronmateriaal herstellen. Retrieval haalt op wat in de index staat, dus verouderde of tegenstrijdige documenten leveren verouderde of tegenstrijdige antwoorden op.
Builds a per-user graph of dated facts from data and conversations and returns the context a task needs in one call.
Context- en geheugenlaag voor AI-agents die beheerde kennisgrafen opbouwt uit bedrijfsdata, documenten en gesprekken.
Tool bekijken
5
Fase 5: Agentframeworks en toegang tot tools
Moet de app acties uitvoeren en niet alleen antwoorden, dan bouw je een agentlus: het model beslist welke tool het aanroept, jouw code voert die uit en geeft het resultaat terug. Je bepaalt de tools, hun rechten en wanneer een mens moet bevestigen.
Wat AI hier doet
Bibliotheken leveren om agenten te schrijven met elke modelaanbieder, toolschema’s genereren uit gewone functies en de authenticatie bij toolservers van derden beheren.
Wat AI hier niet kan
Een agent standaard veilig maken. Elke tool die je beschikbaar stelt, kan het model op het verkeerde moment aanroepen, dus beperk rechten strak en bevestig onomkeerbare acties.
Verbindt een agent met MCP-servers uit een catalogus en beheert OAuth, inloggegevens en sessies voor die verbindingen.
Register en verbindingslaag die AI-agents koppelt aan MCP-servers, met beheerde OAuth en inloggegevens.
Tool bekijken
6
Fase 6: De code schrijven
Rond het model zit een gewone applicatie: API-routes, datamodellen, authenticatie, achtergrondtaken, een gebruikersinterface. Je schrijft, reviewt en test die code, steeds vaker door taken aan een codeeragent te delegeren en zijn wijzigingen na te lopen.
Wat AI hier doet
Een codebase verkennen, een wijziging plannen, bestanden aanpassen, tests draaien en een pull request openen vanuit een taak in gewone taal, en pull requests regel voor regel reviewen.
Wat AI hier niet kan
De architectuur of de gevolgen dragen. Gegenereerde code kan zijn tests doorstaan en toch onveilig zijn of niet aan je eisen voldoen, dus een ontwikkelaar moet lezen wat er wordt samengevoegd.
Plant programmeertaken, bewerkt bestanden, draait tests en opent pull requests in je repository, en vraagt toestemming voordat hij bestanden wijzigt of commando’s uitvoert.
De AI-codeeragent van Anthropic die plant, code bewerkt, tests draait en pull requests opent vanuit je terminal of IDE.
Reviewt elke pull request met opmerkingen per regel en suggesties die je direct kunt committen, wat helpt als een groot deel van de code door agenten is geschreven.
AI-codereview die commentaar geeft op elke pull request, met PR-triage, uitleg bij wijzigingen en beveiligingsmonitoring.
Tool bekijken
7
Fase 7: Spraak-, beeld- en videofuncties
Sommige apps hebben meer nodig dan tekst: gesproken antwoorden, transcriptie, spraakgesprekken in realtime, gegenereerde afbeeldingen of clips. Dat zijn aparte modellen met eigen API’s, latentiebudgetten en gebruiksregels.
Wat AI hier doet
Via een API tekst-naar-spraak, spraak-naar-tekst en full-duplex spraakgesprekken toevoegen, en video of afbeeldingen genereren vanuit applicatiecode.
Wat AI hier niet kan
Voor je de rechten regelen. Voor het klonen van de stem van een echt persoon is diens toestemming nodig, en commercieel gebruik van gegenereerde media hangt af van de voorwaarden van de aanbieder en van je abonnement.
Stelt zijn video- en beeldgeneratiemodellen beschikbaar via een ontwikkelaars-API met documentatie en een modelrouter.
AI-platform voor het genereren en bewerken van video, afbeeldingen en audio, met een API voor ontwikkelaars en world models.
Tool bekijken
8
Fase 8: Evaluatie en monitoring
Je bouwt een testset uit echte invoer, scoort de uitvoer vóór elke wijziging en volgt na de lancering elk verzoek, zodat fouten, kosten en latentie zichtbaar zijn. Menselijke beoordeling dekt wat automatisch scoren niet kan beoordelen.
Wat AI hier doet
Elke stap van een run vastleggen, datasets bouwen uit echte traces, geautomatiseerde evaluatoren draaien op problemen zoals hallucinaties en uitvoer in een wachtrij zetten voor menselijke scoring.
Wat AI hier niet kan
Bepalen wat een goed antwoord is voor jouw product. Iemand moet de criteria schrijven en voorbeelden labelen, en geautomatiseerde beoordelaars zijn zelf modellen die fouten maken.
De AI-observability volgt de gebeurtenissen die de modelaanroepen van een applicatie genereren, naast sessiereplays en foutopsporing voor de rest van de app.
Dataplatform voor producten dat analyse, sessie-opnames, feature flags, foutopsporing en een datawarehouse combineert, met AI erbovenop.
Tool bekijken
9
Fase 9: De app uitrollen
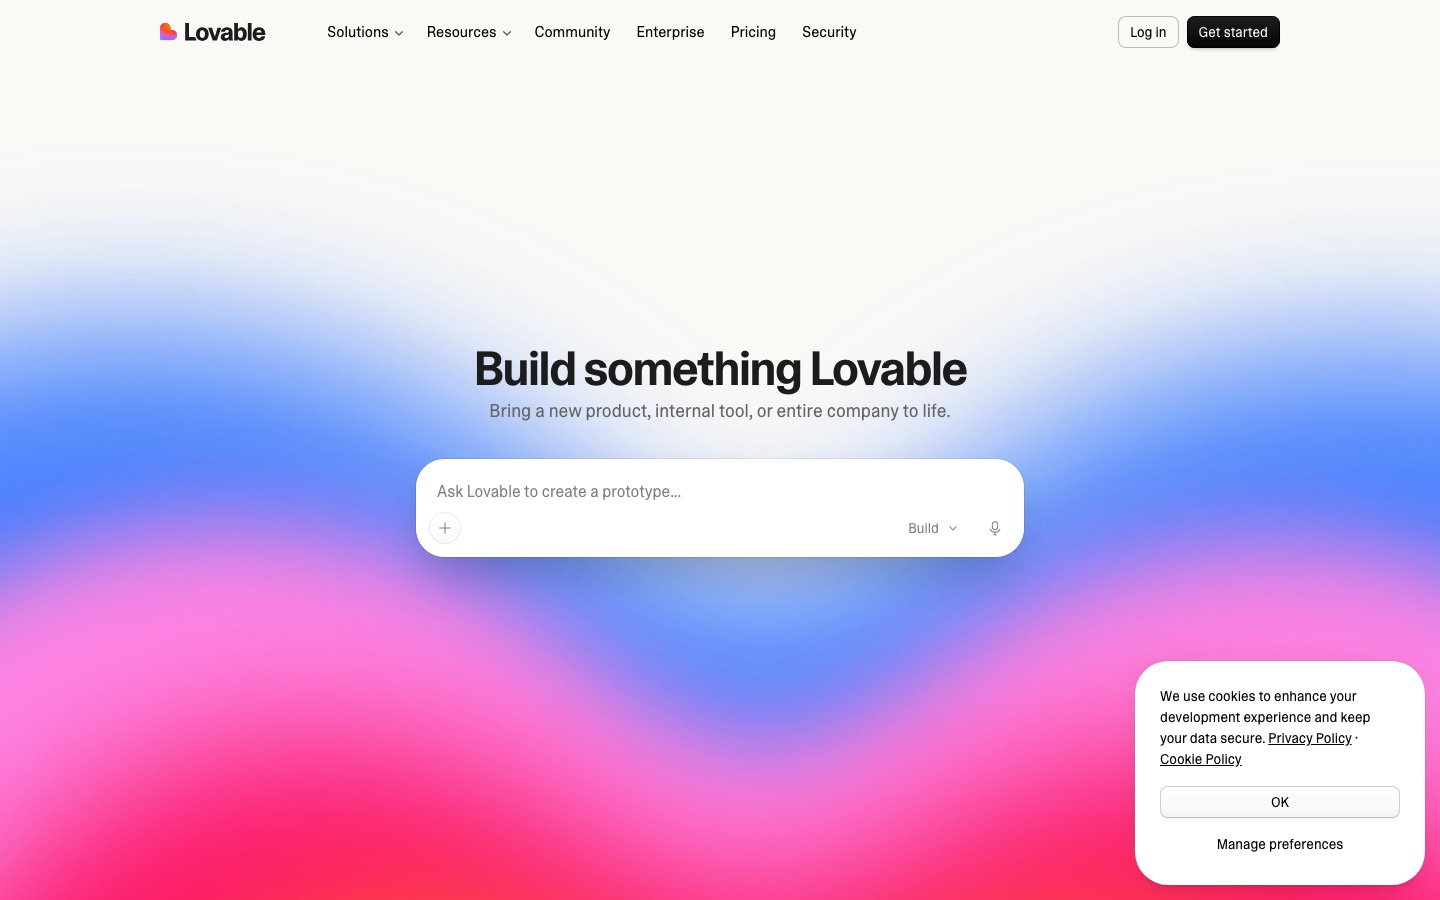
De app heeft een front-end nodig, gebruikersaccounts, hosting, een domein en een releaseproces met previews en rollback. Voor een prototype of interne tool kan dit gegenereerd worden, voor een product is het weloverwogen engineering.
Wat AI hier doet
Een werkende webapp met interface, logica en datalaag genereren uit een beschrijving, bij elke codepush uitrollen en elke wijziging een previewadres geven.
Wat AI hier niet kan
Voor je afhandelen wat na de lancering komt: misbruik, ratelimiting, privacyverzoeken, support en een gebruiksrekening die met elke gebruiker groeit.
Regelt registraties en logins en stelt databasetabellen beschikbaar via REST-endpoints, zodat de app een backend heeft zonder eigen servercode.
Postgres-ontwikkelplatform met authenticatie, directe API's, edge functions, realtime, opslag en vectorembeddings.
Vanaf $ 25/mndTool bekijken
Realistische verwachtingen
Modellen hebben stellig ongelijk
Een taalmodel kan een vloeiend antwoord geven dat onwaar is, en retrieval beperkt dit zonder het weg te nemen. Toon bronnen waar dat kan, test met echte invoer en laat ongecontroleerde uitvoer geen beslissingen over gezondheid, geld of juridische kwesties sturen.
Gebruikersdata en voorwaarden van aanbieders
Elke prompt die je verstuurt, kan persoonlijke of vertrouwelijke gegevens bevatten. Lees de voorwaarden van elke aanbieder over bewaren en trainen, vertel gebruikers wat er wordt verwerkt en overweeg zelf gehoste inferentie of inferentie in een enclave voor gevoelige workloads.
Kosten groeien mee met het gebruik
Tokens, credits, GPU-seconden en toolaanroepen worden allemaal gemeten. Een functie die in de testfase weinig kost, kan duur worden bij lange contexten of agentlussen, dus stel bestedingslimieten in en meet de kosten per verzoek.
Gegenereerde code moet nog steeds gereviewd worden
Codeeragenten en appbuilders leveren snel werkende software op, ook software met beveiligingslekken. Controleer zelf de authenticatie, de regels voor toegang tot data en de omgang met geheimen voordat echte gebruikers komen.
Prompt injection is een echte aanval
Tekst die het model leest op webpagina’s, in documenten of van gebruikers kan instructies bevatten. Behandel uitvoer van het model als onbetrouwbaar, beperk welke tools een agent mag aanroepen en eis bevestiging voor alles wat onomkeerbaar is.
Veelgestelde vragen
Moet ik een gehoste model-API aanroepen of zelf een open model draaien?
Begin met een gehoste API, tenzij je een duidelijke reden hebt om dat niet te doen. Daarop bouw je sneller en je hebt geen GPU-beheer nodig. Zelf een open model draaien is zinvol als data in je eigen omgeving moet blijven, als je wilt finetunen of als het volume zo hoog is dat eigen rekenkracht goedkoper uitkomt. Veel teams prototypen op een API en bekijken de keuze opnieuw zodra het gebruik bekend is.
Heb ik een agentframework nodig om een AI-app te bouwen?
Vaak niet. Eén modelaanroep met goede instructies en opgehaalde context dekt veel functies: samenvatten, indelen, informatie uitlezen, antwoorden uit documenten. Een framework verdient zijn plek als het model uit tools moet kiezen, meerdere stappen moet doorlopen, een toestand moet bijhouden of fouten moet opvangen. Een framework vroeg toevoegen brengt ook extra concepten mee om te debuggen, dus begin eenvoudig en neem het in gebruik zodra de eenvoudige aanpak niet meer volstaat.
Kan iemand zonder programmeerervaring met deze tools een AI-app bouwen?
Een prototype of interne tool wel. Appbuilders in deze gids genereren uit een beschrijving een werkende webapp met login en hosting. Een product dat klantgegevens en betalingen verwerkt, is iets anders: iemand moet verstand hebben van beveiliging, kosten en foutafhandeling. Een verstandige route is zonder code prototypen, testen met echte gebruikers en pas dan een ontwikkelaar erbij halen voordat je opschaalt.
Hoe weet ik of mijn AI-functie goed genoeg is om te lanceren?
Verzamel een set echte invoeren, schrijf voor elke invoer op hoe een goed antwoord eruitziet en scoor het systeem daaraan vóór elke wijziging. Neem moeilijke en vijandige gevallen mee. Combineer automatische controles met menselijke beoordeling van een steekproef. Lanceer voor een kleine groep met tracing aan, lees de fouten en geef steeds meer mensen toegang naarmate het foutpercentage voor jouw toepassing aanvaardbaar wordt.
Een redacteur deelt de tools in bij een fase, op basis van het profiel van elke tool. De lijst groeit naarmate er meer profielen verschijnen. Alle gidsen

 Modal

 Zep

 Firecrawl

 Vercel

 Supabase
 Prompt Cowboy
 Lovable

 LangChain
 v0