
Context.dev
Web-Scraping-API für KI-Agenten, die Seiten als Markdown, HTML, Screenshots oder strukturierte Daten liefert, mit Crawling und Überwachung.
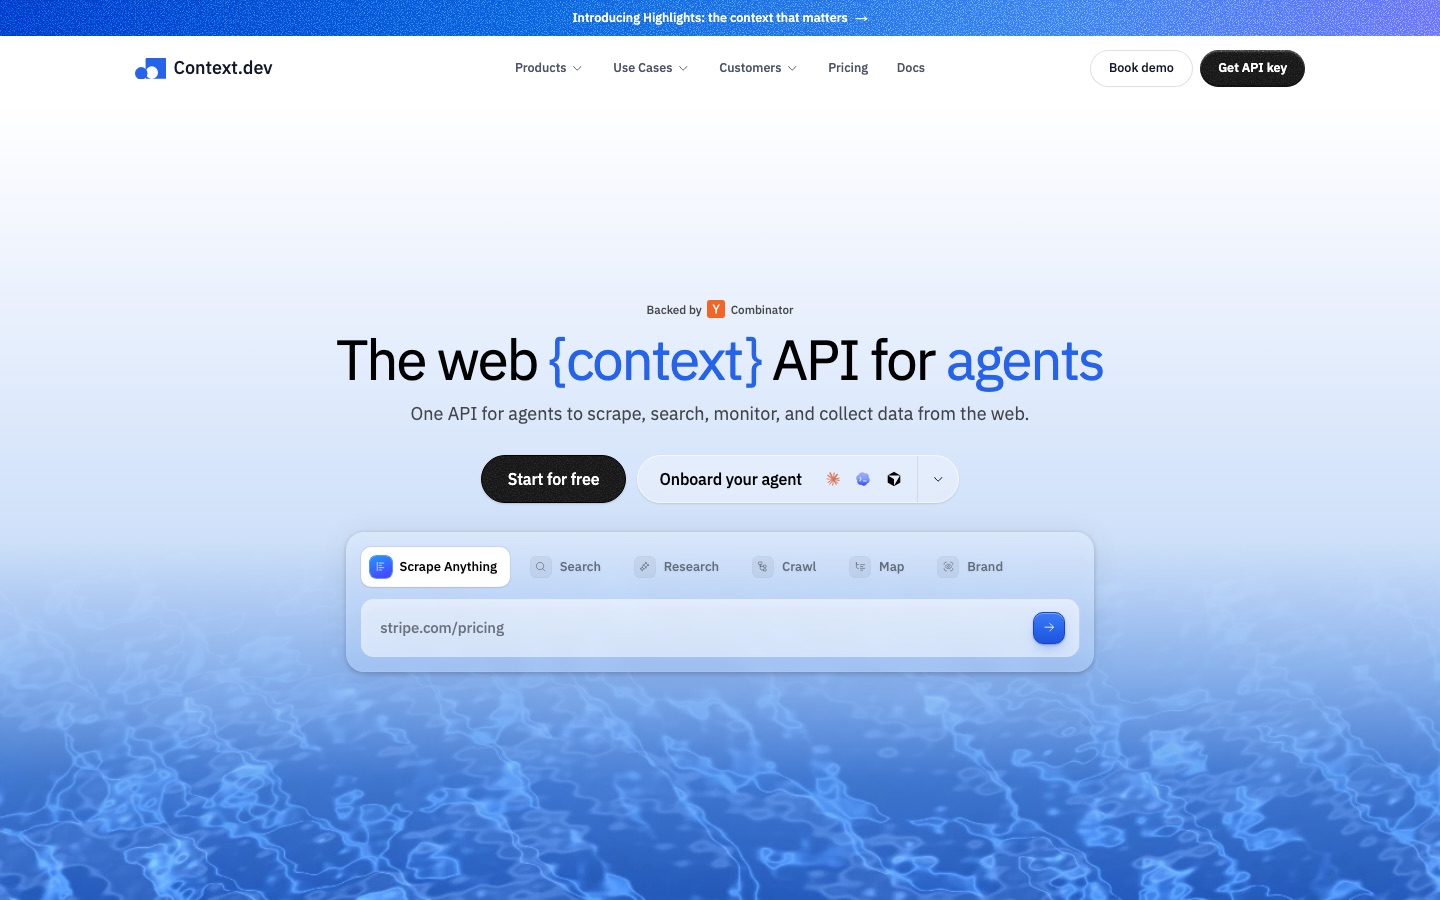
Context.dev ist eine Web-Scraping-API für KI-Agenten und LLM-Produkte. Context.dev wandelt URLs in Markdown, HTML, Screenshots oder strukturiertes JSON um, crawlt ganze Websites, führt Batch-Jobs aus, überwacht Seiten auf Änderungen und liefert Antworten mit Quellen. Context.dev nutzt du, indem du einen API-Schlüssel holst, ein SDK installierst und die Endpunkte aufrufst; die Nutzung wird in Credits gezählt.
Am besten geeignet für Entwickler, die KI-Agenten, RAG-Pipelines oder Datenfunktionen bauen und sauberen Webinhalt brauchen, ohne Browser und Proxys zu verwalten.
- Plattformen
- API, Web
- Preismodell
- Freemium
- Kostenloser Tarif
- Ja
- API
- Ja
- Anbieter
- Context.dev
- Hinzugefügt
Zuletzt geprüft: . Die Angaben stammen von context.dev.
Was ist Context.dev?
Context.dev ist eine Webdaten-API für KI-Agenten und LLM-Anwendungen. Eine einzige REST-Schnittstelle deckt mehrere Aufgaben ab: eine URL in Markdown, HTML, Bilder, einen Screenshot oder Felder nach einem JSON-Schema scrapen; die URLs einer Domain abbilden; eine ganze Website crawlen; Batch-Jobs über Tausende Adressen ausführen; Seiten nach Zeitplan beobachten und Änderungen an einen Webhook senden; und Rechercheanfragen mit zitierten Quellen beantworten. Ein weiterer Endpunkt liefert aus einer Domain das Markenprofil und das Designsystem eines Unternehmens. Jede Anfrage wird in einem echten Browser gerendert, und Proxy-Eskalation und Wiederholungen übernimmt der Dienst, sodass es keine Einstellungen für Rendering oder Proxys zu wählen gibt. Die Nutzung wird in Credits aus einem einzigen Guthaben abgerechnet, beginnend mit einem kostenlosen Monatskontingent. Offizielle SDKs gibt es für fünf Sprachen, und die Einrichtung lässt sich an einen Coding-Agenten übergeben.
Wichtigste Funktionen
Scrape
Macht aus einer Webseite oder einem PDF in einer Anfrage Markdown, HTML, Bilder, einen Screenshot oder strukturierte Felder.
Map und Crawl
Listet die auf einer Domain gefundenen URLs auf und wandelt bis zu 500 Seiten pro Aufruf in Markdown um, mit Steuerung von Tiefe und Mustern.
Batches
Verarbeitet große URL-Listen oder Crawls ganzer Websites als Hintergrundjob und liefert Ergebnisse seitenweise oder per Webhook bei Abschluss.
Monitors
Prüft Seiten nach Zeitplan erneut und sendet erkannte Änderungen, etwa einen neuen Preis, an deinen Webhook.
Answers
Recherchiert eine Frage im Web und liefert eine strukturierte Antwort zusammen mit den Quell-URLs.
Brand Data
Ruft aus einem Domainnamen ein Unternehmensprofil, ein Logo und einen Styleguide der Website ab.
So funktioniert Context.dev
API-Schlüssel holen
Registriere dich, bestätige deine E-Mail-Adresse und kopiere den Schlüssel aus dem Dashboard, oder lass einen Coding-Agenten die Einrichtung nach einer einzeiligen Anweisung übernehmen.
Festlegen, was abgerufen wird
Entscheide zwischen dem Scrapen einer URL, dem Abbilden einer Domain und dem Crawlen einer ganzen Website; alle nutzen denselben Schlüssel.
Integrieren
Installiere ein SDK und rufe die API mithilfe der Dokumentation und von Beispielcode aus deinem Workflow auf.
Live gehen
Speise die zurückgelieferten Daten in Agenten, Retrieval-Pipelines, Recherche- oder Automatisierungsfunktionen ein.
Screenshots
Anwendungsfälle
- Einen RAG-Index mit Grundlage versorgen
- Dokumentationsseiten als Markdown sammeln und die geänderten aktualisieren.
- Einen Chatbot für die Website bauen
- Die gesamte Website eines Kunden crawlen, um die Wissensbasis für einen Support-Bot zu erstellen.
- Preisbeobachtung
- Preisseiten von Wettbewerbern überwachen und einen Webhook erhalten, wenn sich Zahlen ändern.
- Automatisches Ausfüllen beim Onboarding
- Das Unternehmensprofil und die Markenfarben eines neuen Nutzers aus seiner Domain ziehen, um die Einrichtung vorauszufüllen.
- Rechercheaufgaben für Agenten
- Einem Agenten Antworten mit Quellen auf Sachfragen geben statt roher Suchergebnisse.
Gut zu wissen
- Credits unterscheiden sich je nach Endpunkt
- Ein einfaches Scrape kostet 1 Credit, doch JSON-Extraktion, Antworten, Markenabruf und Personenanreicherung verbrauchen jeweils mehr.
- Was bei null Credits passiert
- Kostenpflichtige Tarife können automatisch in Blöcken zu 1.000 Credits aufstocken; ohne Credits oder Aufstockung geben Anfragen einen Fehler wegen überschrittener Nutzung zurück.
- Grenzen bei gleichzeitigen Anfragen
- Die Zahl gleichzeitiger Anfragen ist pro Tarif begrenzt, von einer im kostenlosen Tarif bis 500 bei Scale.
- Rabatt für Start-ups und Non-Profits
- Berechtigte Organisationen können eine Ermäßigung von 30 % auf einen kostenpflichtigen Jahrestarif beantragen, gültig für zwölf Monate.
Häufige Fragen
Was ist Context.dev?
Context.dev ist eine Web-Scraping-API für KI-Agenten und LLM-Pipelines, die Webseiten über eine einzige REST-Schnittstelle scrapt, crawlt, durchsucht und überwacht.
Ist Context.dev kostenlos?
Ja, es gibt einen kostenlosen Tarif. Context.dev gibt jeden Monat 1.000 API-Credits, ohne nach einer Kreditkarte zu fragen, was 1.000 Standard-Scrapes entspricht.
Was kostet Context.dev?
Context.dev: Ein kostenloser Tarif ist verfügbar. Die Preise der kostenpflichtigen Tarife stehen auf context.dev. Die aktuellen Beträge findest du auf der offiziellen Preisseite.
Wie funktionieren die Credits bei Context.dev?
Ein normales Scrape bei Context.dev verbraucht 1 Credit. Browseraktionen, JSON-Extraktion, Antworten und Markenabfragen kosten mehr, zum Beispiel 5 Credits für eine Seite mit JSON-Extraktion.
Berechnet Context.dev extra für JavaScript-Rendering oder Proxys?
Nein. Context.dev schließt Rendering, Umgang mit Anti-Bot-Schutz und Proxys in den Grundpreis eines Scrapes ein.
Welche SDKs bietet Context.dev?
Context.dev veröffentlicht offizielle SDKs für Python, TypeScript, Go, Ruby und PHP.
Werden mir fehlgeschlagene Anfragen bei Context.dev berechnet?
Meistens nicht. Laut Context.dev sind die meisten fehlgeschlagenen Anfragen kostenlos, während 404-Antworten zum Grundpreis der Anfrage berechnet werden.
Kann Context.dev eine ganze Website crawlen?
Ja. Ein Crawl-Aufruf bewältigt bis zu 500 Seiten, und für größere Websites empfiehlt Context.dev Batches im Crawl-Modus.
Für wen es sich eignet
- KI-Ingenieure
- Entwickler von Agenten
- RAG-Teams
- Produktteams im SaaS-Bereich
- Dateningenieure
Kommentare
Noch keine Kommentare. Hast du Context.dev schon genutzt? Erzähl den anderen, wie es lief.
Alternativen zu Context.dev
| Tool | Kostenloser Tarif | Einstiegspreis | API |
|---|---|---|---|
 FirecrawlWeb-Daten-API, die Websites durchsucht, ausliest, crawlt und bedient und für KI-Anwendungen saubere Ausgaben liefert. |
Ja | 16 $/Monat | Ja |
 CrawlbaseInfrastruktur für Web-Crawling und Scraping mit Crawling-API, rotierendem Proxy, verwalteten Scrapern und einem MCP-Server. |
Ja | — | Ja |
 Axiom.aiTool für Browser-Automatisierung und Web-Scraping mit No-Code-Chrome-Erweiterung, Entwickler-APIs und MCP-Server. |
— | — | Ja |
 ScrapelessWebdaten und Cloud-Browser-Infrastruktur für KI-Agenten: Agent Browser, KI-Scraper, Web Unlocker, Crawl und Proxys. |
— | — | Ja |
 TinyFishWeb-Infrastruktur für KI-Agenten: APIs für Suche, Abruf, Cloud-Browser und autonome Web-Agenten hinter einem Schlüssel. |
Ja | — | Ja |
Aus denselben Kategorien wie Context.dev. Ein Einstiegspreis steht nur dort, wo wir ihn auf der Preisseite des Anbieters geprüft haben. Ein Strich bedeutet: nicht geprüft oder nicht veröffentlicht. Alle Tools in Web Scraping und Datenextraktion