
Context.dev
Webscraping-API voor AI-agents die pagina's teruggeeft als Markdown, HTML, screenshots of gestructureerde data, met crawlen en monitoren.
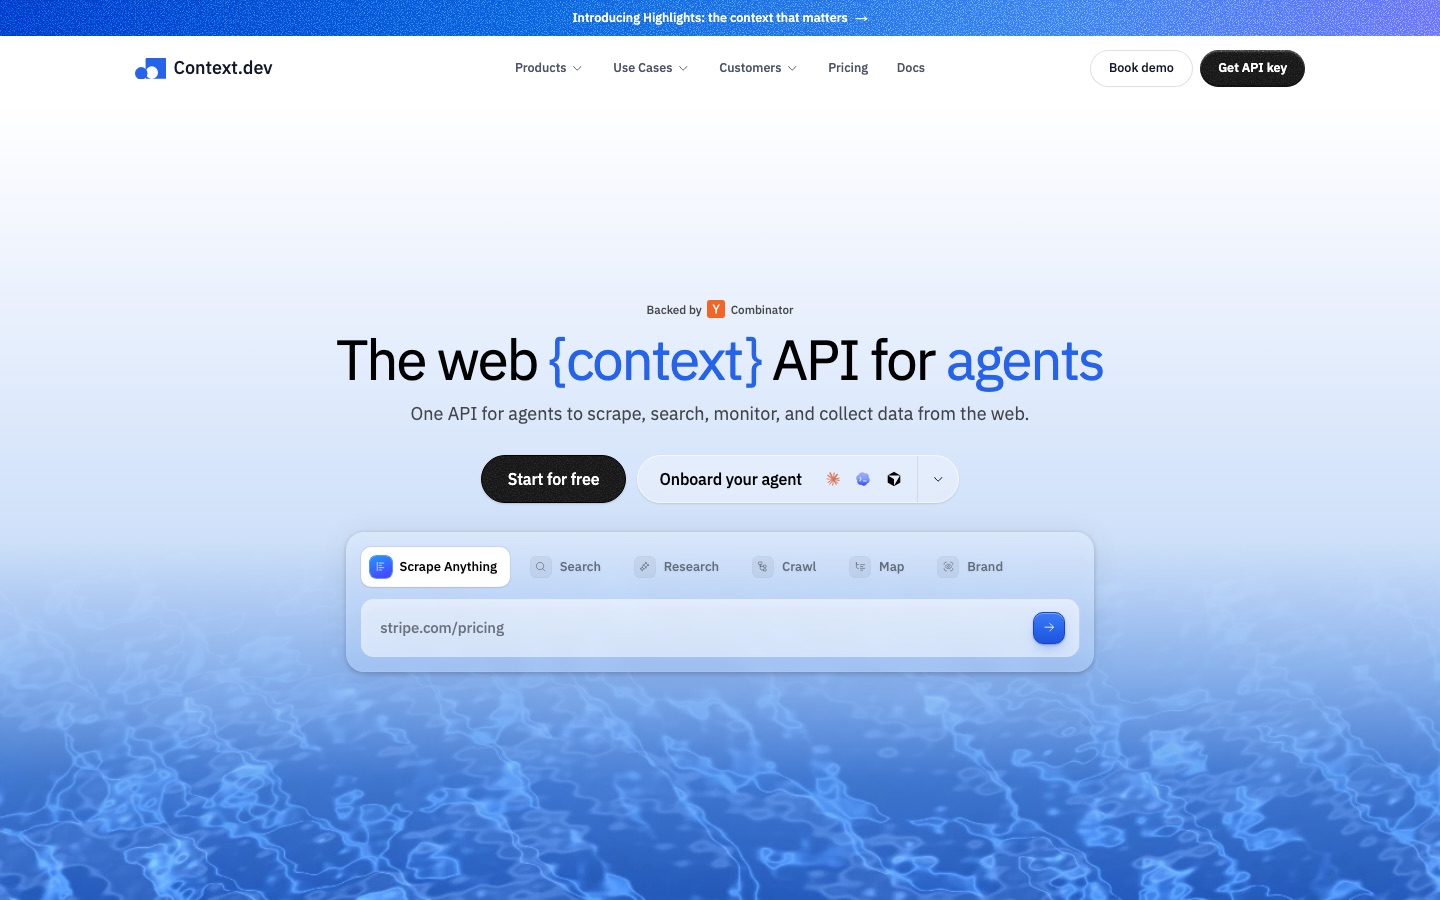
Context.dev is een webscraping-API voor AI-agents en LLM-producten. Context.dev zet URL's om in Markdown, HTML, screenshots of gestructureerde JSON, crawlt hele websites, draait batchtaken, monitort pagina's op wijzigingen en geeft antwoorden met bronvermelding. Je gebruikt Context.dev door een API-sleutel te nemen, een SDK te installeren en de endpoints aan te roepen, waarbij het gebruik in credits wordt geteld.
Geschikt voor Ontwikkelaars die AI-agents, RAG-pipelines of datafuncties bouwen en schone webcontent nodig hebben zonder browsers en proxy's te beheren.
- Platforms
- API, Web
- Prijsmodel
- Freemium
- Gratis abonnement
- Ja
- API
- Ja
- Gemaakt door
- Context.dev
- Toegevoegd
Laatst gecontroleerd: . Informatie overgenomen van context.dev.
Wat is Context.dev?
Context.dev is een web-data-API die is gebouwd voor AI-agents en LLM-toepassingen. Eén REST-interface dekt meerdere taken: een URL scrapen naar Markdown, HTML, afbeeldingen, een screenshot of velden die met een JSON-schema zijn gedefinieerd; de URL's van een domein in kaart brengen; een hele website crawlen; batchtaken draaien over duizenden adressen; pagina's volgens een schema in de gaten houden en wijzigingen naar een webhook sturen; en onderzoeksvragen beantwoorden met bronnen die worden genoemd. Een ander endpoint geeft het merkprofiel en het designsysteem van een bedrijf terug op basis van het domein. Elk verzoek wordt in een echte browser gerenderd, en het opschalen van proxy's en het opnieuw proberen gebeuren aan de kant van de dienst, dus er zijn geen instellingen voor renderen of proxy's om te kiezen. Het gebruik wordt gemeten in credits uit één saldo, te beginnen met een gratis maandelijks tegoed. Er zijn officiële SDK's voor vijf talen, en de installatie kan worden overgelaten aan een coding-agent.
Belangrijkste functies
Scrape
Zet een webpagina of pdf in één verzoek om in Markdown, HTML, afbeeldingen, een screenshot of gestructureerde velden.
Map en Crawl
Geeft een lijst van de URL's op een domein en zet per aanroep tot 500 pagina's om in Markdown, met instellingen voor diepte en patronen.
Batches
Verwerkt grote lijsten met URL's of crawls van hele websites als achtergrondtaak en geeft resultaten in pagina's terug of een webhook bij voltooiing.
Monitors
Controleert pagina's opnieuw volgens een schema en stuurt gedetecteerde wijzigingen, zoals een nieuwe prijs, naar je webhook.
Answers
Zoekt een vraag op het web uit en geeft een gestructureerd antwoord terug, samen met de URL's van de bronnen.
Brand Data
Haalt een bedrijfsprofiel, logo en stijlgids van een website op uit een domeinnaam.
Zo werkt Context.dev
Neem een API-sleutel
Registreer je, verifieer je e-mailadres en kopieer de sleutel uit het dashboard, of laat een coding-agent de installatie doen met een instructie van één regel.
Kies wat je ophaalt
Kies tussen het scrapen van één URL, het in kaart brengen van een domein of het crawlen van een hele website; alle gebruiken dezelfde sleutel.
Integreren
Installeer een SDK en roep de API aan vanuit je workflow met behulp van de documentatie en voorbeeldcode.
Live zetten
Voed de teruggegeven data aan agents, retrieval-pipelines, onderzoek of automatiseringsfuncties.
Screenshots
Toepassingen
- Een RAG-index onderbouwen
- Verzamel documentatiepagina's als Markdown en ververs de pagina's die veranderen.
- Een chatbot voor een website bouwen
- Crawl de hele website van een klant om de kennisbank achter een supportbot te maken.
- Prijzen volgen
- Monitor prijspagina's van concurrenten en ontvang een webhook wanneer cijfers veranderen.
- Automatisch invullen bij onboarding
- Haal het bedrijfsprofiel en de huiskleuren van een nieuwe gebruiker op uit het domein om de instellingen vooraf in te vullen.
- Onderzoekstaken voor agents
- Geef een agent antwoorden met bronnen op feitelijke vragen in plaats van ruwe zoekresultaten.
Goed om te weten
- Credits verschillen per endpoint
- Een gewone scrape kost 1 credit, maar JSON-extractie, answers, het ophalen van merkgegevens en verrijking van personen kosten elk meer.
- Wat er gebeurt bij nul credits
- Betaalde abonnementen kunnen automatisch worden aangevuld in blokken van 1.000 credits; zonder credits of aanvulling geven verzoeken de foutmelding dat het gebruik is overschreden.
- Limieten voor gelijktijdigheid
- Het aantal gelijktijdige verzoeken is per abonnement begrensd, van één in het gratis niveau tot 500 bij Scale.
- Korting voor startups en non-profitorganisaties
- Organisaties die in aanmerking komen, kunnen 30% korting aanvragen op een betaald jaarabonnement, twaalf maanden geldig.
Veelgestelde vragen
Wat is Context.dev?
Context.dev is een webscraping-API voor AI-agents en LLM-pipelines die webpagina's scrapet, crawlt, doorzoekt en monitort via één REST-interface.
Is Context.dev gratis?
Ja, er is een gratis niveau. Context.dev geeft elke maand 1.000 API-credits zonder dat je om een creditcard wordt gevraagd, genoeg voor 1.000 standaardscrapes.
Hoeveel kost Context.dev?
Context.dev heeft een gratis abonnement. De tarieven van de betaalde abonnementen staan op context.dev. Bekijk de officiële prijspagina voor de actuele bedragen.
Hoe werken de credits van Context.dev?
Een standaardscrape met Context.dev gebruikt 1 credit. Browseracties, JSON-extractie, answers en opzoekingen van merkgegevens kosten meer, bijvoorbeeld 5 credits voor een pagina met JSON-extractie.
Rekent Context.dev extra voor JavaScript-rendering of proxy's?
Nee. Context.dev neemt rendering, afhandeling van anti-botmaatregelen en proxy's op in de basisprijs van een scrape.
Welke SDK's biedt Context.dev?
Context.dev publiceert officiële SDK's voor Python, TypeScript, Go, Ruby en PHP.
Word ik gefactureerd voor mislukte verzoeken aan Context.dev?
Meestal niet. Context.dev zegt dat de meeste mislukte verzoeken gratis zijn, terwijl 404-antwoorden worden berekend tegen de basisprijs van het verzoek.
Kan Context.dev een hele website crawlen?
Ja. Eén crawlaanroep verwerkt tot 500 pagina's, en Context.dev raadt voor grotere websites batches in de crawlmodus aan.
Voor wie
- AI-engineers
- Agentontwikkelaars
- RAG-teams
- Productteams van SaaS-bedrijven
- Data-engineers
Reacties
Nog geen reacties. Heb je Context.dev gebruikt? Vertel andere lezers hoe het ging.
Alternatieven voor Context.dev
| Tool | Gratis abonnement | Vanafprijs | API |
|---|---|---|---|
 FirecrawlWebdata-API die websites doorzoekt, scrapet, crawlt en er interactie mee heeft, en schone uitvoer voor AI-toepassingen levert. |
Ja | $ 16/mnd | Ja |
 CrawlbaseInfrastructuur voor webcrawling en scraping met een crawling-API, roterende proxy, beheerde scrapers en een MCP-server. |
Ja | — | Ja |
 Axiom.aiTool voor browserautomatisering en webscraping met een Chrome-extensie zonder code, API’s voor ontwikkelaars en een MCP-server. |
— | — | Ja |
 ScrapelessWebdata en cloudbrowserinfrastructuur voor AI-agents: agentbrowser, AI-scrapers, web unlocker, crawler en proxy’s. |
— | — | Ja |
 TinyFishWebinfrastructuur voor AI-agents: API’s voor zoeken, ophalen, een cloudbrowser en een autonome webagent achter één sleutel. |
Ja | — | Ja |
Staan in dezelfde categorieën als Context.dev. Een vanafprijs staat er alleen als we die op de prijspagina van de maker hebben gecontroleerd; een streepje betekent niet gecontroleerd of niet gepubliceerd. Alle tools in de categorie Webscraping en data-extractie