
Crawlbase
Infrastruktur für Web-Crawling und Scraping mit Crawling-API, rotierendem Proxy, verwalteten Scrapern und einem MCP-Server.
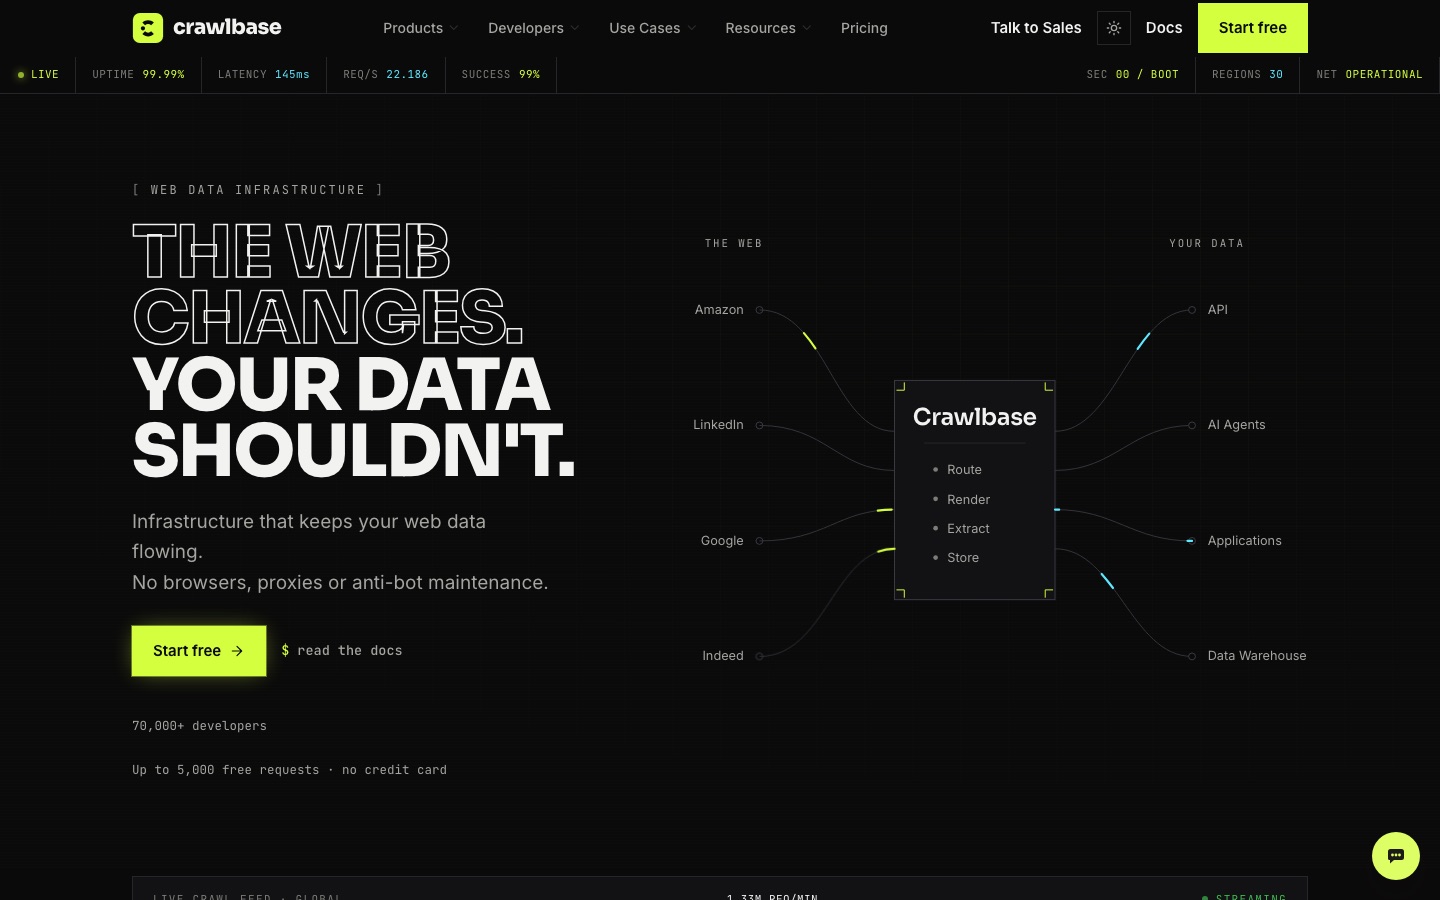
Crawlbase ist eine Plattform für Webdaten, gedacht für Entwickler und KI-Teams. Crawlbase nimmt über seine API eine URL entgegen und liefert HTML oder strukturiertes JSON zurück, wobei Proxy-Rotation, JavaScript-Rendering und Anti-Bot-Prüfungen auf seiner Seite erledigt werden. Außerdem gibt es einen asynchronen Crawler, einen Proxy-Endpunkt, Cloud-Speicher und einen MCP-Server für KI-Agenten.
Am besten geeignet für Entwickler und Datenteams, die Webseiten zuverlässig und in großer Menge abrufen und auswerten wollen, ohne eigene Proxys und Headless-Browser zu betreiben.
- Plattformen
- API, MCP
- Preismodell
- Credits
- Kostenloser Tarif
- Ja
- API
- Ja
- Anbieter
- Crawlbase
- Hinzugefügt
Zuletzt geprüft: . Die Angaben stammen von crawlbase.com.
Was ist Crawlbase?
Crawlbase ist eine Infrastruktur für Webdaten, die öffentliche Webseiten im Auftrag von Entwicklern, Unternehmen und Anwendungen mit Sprachmodellen abruft und auswertet. Die Crawling-API nimmt eine URL und ein Token entgegen und antwortet mit HTML, Markdown oder strukturiertem JSON, wobei Seiten in einem echten Browser gerendert werden, wenn JavaScript nötig ist. Der Enterprise Crawler verarbeitet sehr große URL-Stapel asynchron und liefert die Ergebnisse per Callback, während Smart AI Proxy rotierende Residential- und Datacenter-IPs in 30 Regionen hinter einem einzigen Endpunkt bereitstellt. Verwaltete Scraper liefern typisierte Felder für Websites wie Amazon, Google und LinkedIn, Cloud Storage bewahrt gecrawlte Seiten für späteren Abruf auf, und über den Web MCP Server können KI-Agenten per Model Context Protocol aktuelle Seiten anfordern. SDKs gibt es für Python, Node, Go, Ruby, PHP, Java und .NET. Alle Produkte nutzen ein gemeinsames Credit-Guthaben, und abgerechnet werden nur erfolgreiche Anfragen.
Wichtigste Funktionen
Crawling API
Liefert für eine übermittelte URL sauberes HTML oder aufbereitete Daten, mit Rendering und Anti-Bot-Behandlung inklusive.
Enterprise Crawler
Reiht Millionen von URLs ein und schickt die Ergebnisse an deinen Callback, ohne dass du Worker betreiben musst.
Smart AI Proxy
Leitet Anfragen über automatisch rotierte Residential- und Datacenter-IPs über einen einzigen Proxy-Endpunkt.
Verwaltete Scraper
Extrahiert strukturierte Felder von bestimmten stark gefragten Websites und wird von Crawlbase angepasst, wenn sich diese Websites ändern.
Cloud Storage
Speichert Crawl-Ergebnisse, sodass eine Seite erneut aus dem Speicher statt aus der Quelle abgerufen werden kann.
Web MCP Server
Gibt KI-Agenten und RAG-Pipelines über MCP Zugriff auf aktuelle Webseiten.
Anwendungsfälle
- Preis- und Produktbeobachtung
- Sammle Produktdetails und Preise von E-Commerce-Websites nach Zeitplan.
- Verfolgung von Suchergebnissen
- Erfasse Ergebnisseiten von Suchmaschinen in großer Zahl.
- Marktbeobachtung
- Stelle Katalog- und Bewertungsdaten von Marktplätzen und Verzeichnissen zusammen.
- Daten für KI-Anwendungen
- Versorge Modelle und Retrieval-Pipelines mit frischen Webinhalten.
- Workflow-Automatisierung
- Löse Crawls über Integrationen mit n8n, Zapier oder Scrapy aus.
Gut zu wissen
- Rendering und schwierige Websites kosten mehr
- JavaScript-Rendering verdoppelt die Credit-Kosten einer Anfrage, und stark geschützte Websites tragen Schwierigkeitsfaktoren, die bis zum 20-Fachen reichen.
- Speicher und Screenshots verbrauchen Credits
- Eine Seite im Speicher zu halten kostet 0,5 Credits pro Monat, ein Screenshot kostet 2 Credits, jeweils vom selben Guthaben.
- Abo-Credits werden monatlich zurückgesetzt
- Der Credit-Block eines Abos wird in jedem Zyklus zurückgesetzt; darüber hinausgehende Nutzung läuft zu Pay-as-you-go-Preisen weiter, sofern das nicht abgeschaltet wird.
Häufige Fragen
Was ist Crawlbase?
Crawlbase ist eine Infrastruktur für Webdaten, die Websites crawlt und scrapt und über eine Plattform saubere oder strukturierte Daten zurückgibt.
Wie funktioniert die API von Crawlbase?
Du sendest eine URL mit deinem Token; Crawlbase leitet sie über einen rotierenden Proxy, rendert bei Bedarf JavaScript, kümmert sich um CAPTCHAs und Bot-Prüfungen und liefert die Daten zurück.
Ist Crawlbase kostenlos?
Crawlbase hat einen kostenlosen Tarif: Neue Konten erhalten 1.000 kostenlose Credits ohne Karte, die nach Abschluss von Einrichtungsschritten auf bis zu 5.000 steigen.
Was kostet Crawlbase?
Crawlbase: Ein kostenloser Tarif ist verfügbar. Die Preise der kostenpflichtigen Tarife stehen auf crawlbase.com. Die aktuellen Beträge findest du auf der offiziellen Preisseite.
Hat Crawlbase eine API?
Ja. Crawlbase ist um eine HTTP-API herum aufgebaut, mit einer Proxy-Schnittstelle, einem MCP-Server und offiziellen SDKs für sieben Sprachen.
Werden bei Crawlbase fehlgeschlagene Anfragen berechnet?
Nein. Crawlbase berechnet nur erfolgreiche Anfragen; fehlgeschlagene oder blockierte kosten nichts.
Lässt sich Crawlbase mit KI-Agenten verwenden?
Ja. Der Crawlbase Web MCP Server liefert KI-Agenten und LLMs über das Model Context Protocol Live-Webdaten.
Für wen es sich eignet
- Entwickler
- Data Engineers
- KI-Teams
- E-Commerce-Analysten
- Unternehmen
Kommentare
Noch keine Kommentare. Hast du Crawlbase schon genutzt? Erzähl den anderen, wie es lief.
Alternativen zu Crawlbase
| Tool | Kostenloser Tarif | Einstiegspreis | API |
|---|---|---|---|
 Context.devWeb-Scraping-API für KI-Agenten, die Seiten als Markdown, HTML, Screenshots oder strukturierte Daten liefert, mit Crawling und Überwachung. |
Ja | — | Ja |
 FirecrawlWeb-Daten-API, die Websites durchsucht, ausliest, crawlt und bedient und für KI-Anwendungen saubere Ausgaben liefert. |
Ja | 16 $/Monat | Ja |
ScrapingBeeWeb-Scraping-API, die Proxys, Headless-Browser und KI-gestützte Datenextraktion für dich übernimmt. |
— | — | Ja |
 Axiom.aiTool für Browser-Automatisierung und Web-Scraping mit No-Code-Chrome-Erweiterung, Entwickler-APIs und MCP-Server. |
— | — | Ja |
 Elastic StackProduktsuite rund um Elasticsearch für Suche, Observability und Sicherheit, mit Vektorsuche und Werkzeugen für KI-Agenten. |
— | — | Ja |
Aus denselben Kategorien wie Crawlbase. Ein Einstiegspreis steht nur dort, wo wir ihn auf der Preisseite des Anbieters geprüft haben. Ein Strich bedeutet: nicht geprüft oder nicht veröffentlicht. Alle Tools in Web Scraping und Datenextraktion