
Context.dev
API de web scraping para agentes de IA que devuelve páginas como Markdown, HTML, capturas de pantalla o datos estructurados, con rastreo y monitorización.
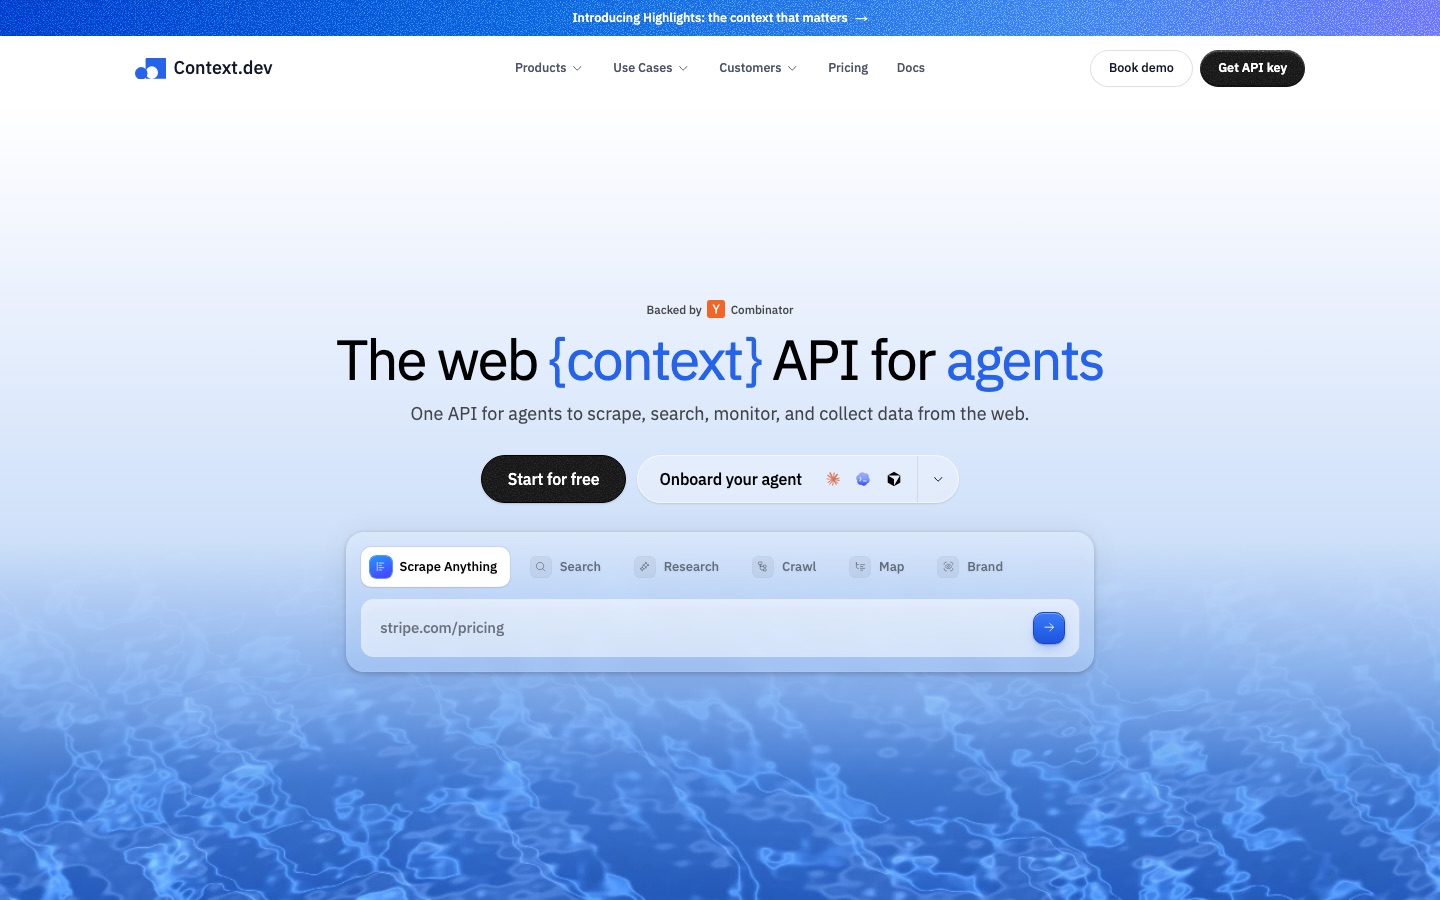
Context.dev es una API de web scraping para agentes de IA y productos con LLM. Context.dev convierte URL en Markdown, HTML, capturas de pantalla o JSON estructurado, rastrea sitios completos, ejecuta trabajos por lotes, vigila cambios en las páginas y devuelve respuestas con fuentes. Context.dev se usa obteniendo una clave de API, instalando un SDK y llamando a los endpoints, con el consumo contado en créditos.
Ideal para Desarrolladores que crean agentes de IA, canalizaciones RAG o funciones de datos y necesitan contenido web limpio sin gestionar navegadores ni proxies.
- Plataformas
- API, Web
- Modelo de precios
- Freemium
- Plan gratuito
- Sí
- API
- Sí
- Desarrollada por
- Context.dev
- Añadida
Última verificación: . Información obtenida de context.dev.
¿Qué es Context.dev?
Context.dev es una API de datos web creada para agentes de IA y aplicaciones con LLM. Una única interfaz REST cubre varias tareas: convertir una URL en Markdown, HTML, imágenes, una captura de pantalla o campos definidos por un esquema JSON; mapear las URL de un dominio; rastrear un sitio completo; ejecutar trabajos por lotes sobre miles de direcciones; vigilar páginas de forma programada y enviar los cambios a un webhook; y responder preguntas de investigación con fuentes citadas. Otro endpoint devuelve el perfil de marca de una empresa y su sistema de diseño a partir de su dominio. Cada solicitud se renderiza en un navegador real, y la escalada de proxies y los reintentos se gestionan en el lado del servicio, así que no hay ajustes de renderizado ni de proxies que elegir. El uso se mide en créditos de un único saldo, con una cuota mensual gratuita para empezar. Hay SDK oficiales para cinco lenguajes, y la configuración se puede delegar en un agente de programación.
Funciones principales
Scrape
Convierte una página web o un PDF en Markdown, HTML, imágenes, una captura de pantalla o campos estructurados con una sola solicitud.
Map y Crawl
Enumera las URL de un dominio y convierte hasta 500 páginas por llamada en Markdown, con controles de profundidad y de patrones.
Batches
Procesa listas grandes de URL o rastreos de sitios completos como un trabajo en segundo plano y devuelve resultados paginados o un webhook al terminar.
Monitors
Vuelve a comprobar páginas de forma programada y envía a tu webhook los cambios detectados, como un precio nuevo.
Answers
Investiga una pregunta en la web y devuelve una respuesta estructurada junto con las URL de las fuentes.
Brand Data
Obtiene el perfil de una empresa, su logotipo y la guía de estilo de su sitio web a partir de un nombre de dominio.
Cómo funciona Context.dev
Obtén una clave de API
Regístrate, verifica tu correo y copia la clave del panel, o pide a un agente de programación que haga la configuración a partir de una instrucción de una línea.
Elige qué obtener
Decide entre hacer scraping de una URL, mapear un dominio o rastrear un sitio completo; todo usa la misma clave.
Intégralo
Instala un SDK y llama a la API desde tu flujo de trabajo con la documentación y el código de ejemplo.
Publícalo
Envía los datos devueltos a agentes, canalizaciones de recuperación, investigación o funciones de automatización.
Capturas de pantalla
Casos de uso
- Alimentar un índice RAG
- Reúne páginas de documentación en Markdown y actualiza las que cambian.
- Crear un chatbot para un sitio
- Rastrea todo el sitio web de un cliente para crear la base de conocimiento de un bot de soporte.
- Seguimiento de precios
- Vigila las páginas de precios de la competencia y recibe un webhook cuando las cifras cambian.
- Autocompletado en el registro
- Obtén el perfil de empresa y los colores de marca de un usuario nuevo a partir de su dominio para rellenar de antemano la configuración.
- Tareas de investigación de agentes
- Da a un agente respuestas con fuentes a preguntas sobre hechos, en lugar de resultados de búsqueda sin procesar.
Lo que debes saber
- Los créditos varían según el endpoint
- Un scrape básico cuesta 1 crédito, pero la extracción de JSON, las respuestas, la obtención de datos de marca y el enriquecimiento de personas consumen más.
- Qué pasa al llegar a cero créditos
- Los planes de pago pueden recargarse automáticamente en bloques de 1.000 créditos; sin créditos ni recarga, las solicitudes devuelven un error de uso excedido.
- Límites de concurrencia
- El número de solicitudes simultáneas está limitado por plan, desde una en el plan gratuito hasta 500 en Scale.
- Descuento para startups y organizaciones sin ánimo de lucro
- Las organizaciones que cumplan los requisitos pueden solicitar una reducción del 30 % en un plan anual de pago, válida durante doce meses.
Preguntas frecuentes
¿Qué es Context.dev?
Context.dev es una API de web scraping para agentes de IA y canalizaciones con LLM que extrae, rastrea, busca y monitoriza páginas web mediante una única interfaz REST.
¿Es gratis Context.dev?
Sí, hay un plan gratuito. Context.dev ofrece 1.000 créditos de API al mes sin pedir tarjeta de crédito, lo que equivale a 1.000 scrapes estándar.
¿Cuánto cuesta Context.dev?
Context.dev tiene un plan gratuito. Las tarifas de los planes de pago se publican en context.dev. Consulta los importes actuales en la página oficial de precios.
¿Cómo funcionan los créditos de Context.dev?
Un scrape estándar de Context.dev usa 1 crédito. Las acciones del navegador, la extracción de JSON, las respuestas y las consultas de marca cuestan más, por ejemplo 5 créditos por una página con extracción de JSON.
¿Cobra Context.dev un extra por el renderizado de JavaScript o los proxies?
No. Context.dev incluye el renderizado, la gestión de sistemas antibot y los proxies en el precio base del scrape.
¿Qué SDK ofrece Context.dev?
Context.dev publica SDK oficiales para Python, TypeScript, Go, Ruby y PHP.
¿Se me cobran las solicitudes fallidas de Context.dev?
Casi nunca. Context.dev indica que la mayoría de las solicitudes fallidas son gratuitas, mientras que las respuestas 404 se cobran al precio base de la solicitud.
¿Puede Context.dev rastrear un sitio web completo?
Sí. Una llamada de rastreo gestiona hasta 500 páginas, y Context.dev recomienda usar lotes en modo de rastreo para sitios más grandes.
Para quién es
- Ingenieros de IA
- Desarrolladores de agentes
- Equipos de RAG
- Equipos de producto SaaS
- Ingenieros de datos
Comentarios
Todavía no hay comentarios. Si has usado Context.dev, cuéntales a otros lectores cómo te fue.
Alternativas a Context.dev
| Herramienta | Plan gratuito | Precio inicial | API |
|---|---|---|---|
 FirecrawlAPI de datos web que busca, extrae, rastrea e interactúa con sitios web, y devuelve resultados limpios para aplicaciones de IA. |
Sí | 16 $/mes | Sí |
 CrawlbaseInfraestructura de rastreo y extracción web con una API de rastreo, proxy rotativo, scrapers gestionados y un servidor MCP. |
Sí | — | Sí |
 Axiom.aiHerramienta de automatización del navegador y web scraping con una extensión de Chrome sin código, API para desarrolladores y un servidor MCP. |
— | — | Sí |
 ScrapelessInfraestructura de datos web y de navegadores en la nube para agentes de IA: navegador para agentes, scrapers con IA, web unlocker, rastreo y proxies. |
— | — | Sí |
 TinyFishInfraestructura web para agentes de IA: API de búsqueda, obtención de páginas, navegador en la nube y agente web autónomo con una sola clave. |
Sí | — | Sí |
Herramientas de las mismas categorías que Context.dev. El precio inicial solo aparece si lo comprobamos en la página de precios del desarrollador; un guion significa que no se comprobó o no está publicado. Todas las herramientas de la categoría Web scraping y extracción de datos