
Context.dev
API di web scraping per agenti di IA che restituisce le pagine come Markdown, HTML, screenshot o dati strutturati, con crawling e monitoraggio.
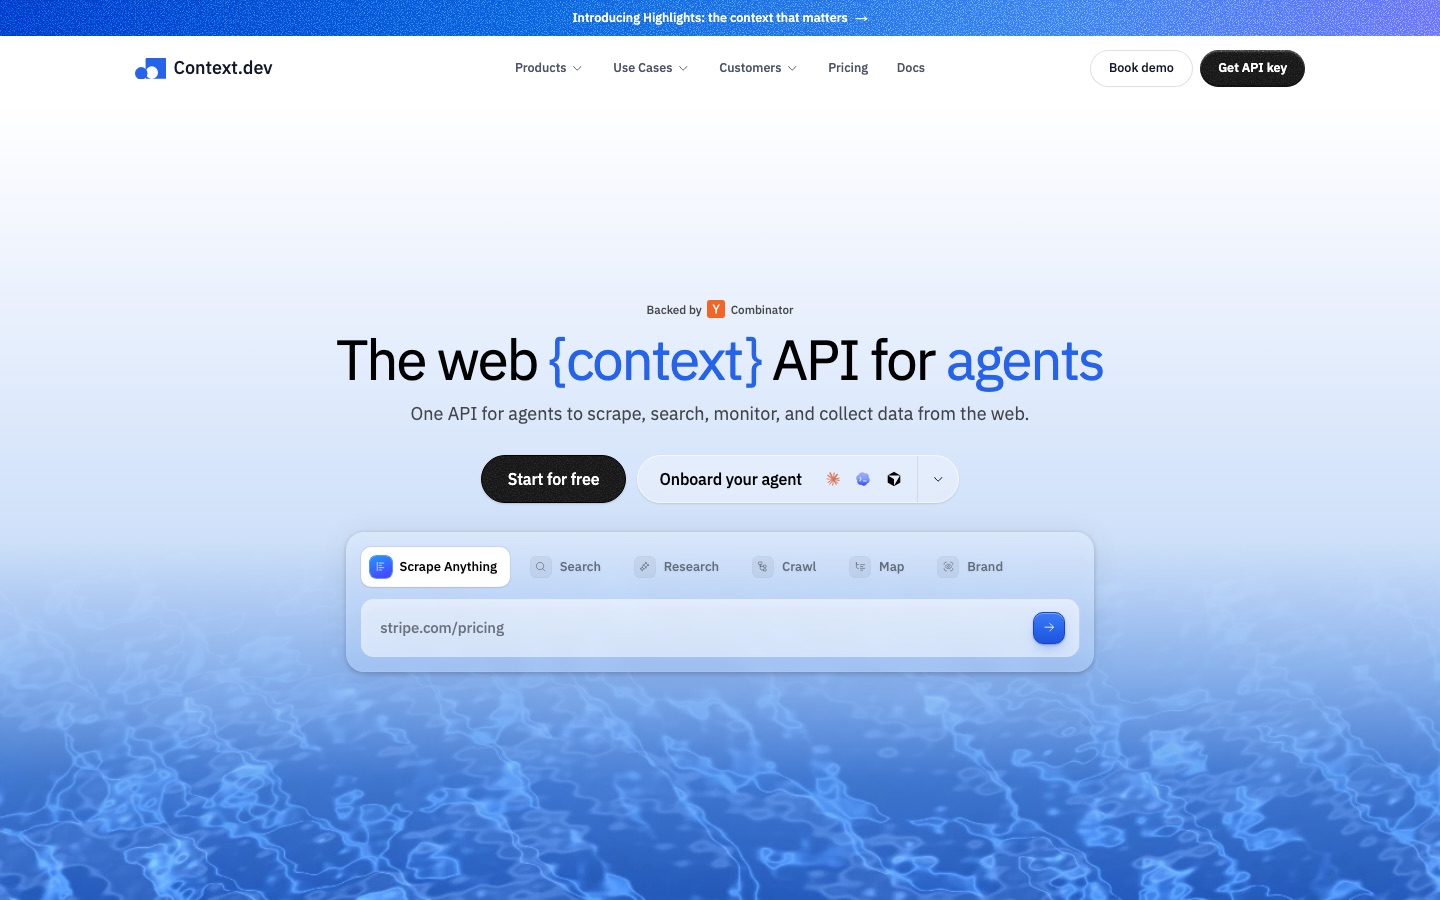
Context.dev è un’API di web scraping per agenti di IA e prodotti basati su LLM. Context.dev converte gli URL in Markdown, HTML, screenshot o JSON strutturato, esegue il crawling di interi siti, lancia lavori in batch, monitora le modifiche alle pagine e restituisce risposte con le fonti. Si usa ottenendo una chiave API, installando un SDK e chiamando gli endpoint, con l’utilizzo conteggiato in crediti.
Indicato per Sviluppatori che costruiscono agenti di IA, pipeline RAG o funzioni basate sui dati e hanno bisogno di contenuti web puliti senza gestire browser e proxy.
- Piattaforme
- API, Web
- Modello di prezzo
- Freemium
- Piano gratuito
- Sì
- API
- Sì
- Sviluppato da
- Context.dev
- Aggiunto
Ultima verifica: . Informazioni tratte da context.dev.
Che cos’è Context.dev?
Context.dev è un’API di dati web pensata per agenti di IA e applicazioni basate su LLM. Una sola interfaccia REST copre vari compiti: fare lo scraping di un URL in Markdown, HTML, immagini, screenshot o campi definiti da uno schema JSON; mappare gli URL di un dominio; fare il crawling di un intero sito; eseguire lavori in batch su migliaia di indirizzi; controllare le pagine a intervalli programmati e inviare le modifiche a un webhook; e rispondere a domande di ricerca citando le fonti. Un altro endpoint restituisce il profilo del brand e il design system di un’azienda a partire dal suo dominio. Ogni richiesta viene elaborata in un browser reale, e l’escalation dei proxy e i nuovi tentativi avvengono lato servizio, quindi non ci sono impostazioni di rendering o di proxy da scegliere. L’utilizzo è misurato in crediti prelevati da un unico saldo, a partire da una quota mensile gratuita. Esistono SDK ufficiali per cinque linguaggi, e la configurazione si può delegare a un agente di programmazione.
Funzioni principali
Scrape
Trasforma una pagina web o un PDF in Markdown, HTML, immagini, uno screenshot o campi strutturati con una sola richiesta.
Map and Crawl
Elenca gli URL trovati in un dominio e converte in Markdown fino a 500 pagine per chiamata, con controlli di profondità e di schema.
Batches
Elabora grandi elenchi di URL o crawling di interi siti come lavoro in background e restituisce risultati paginati o un webhook di completamento.
Monitors
Ricontrolla le pagine a intervalli programmati e invia al tuo webhook le modifiche rilevate, come un nuovo prezzo.
Answers
Ricerca una domanda sul web e restituisce una risposta strutturata insieme agli URL delle fonti.
Brand Data
Recupera il profilo di un’azienda, il logo e la guida di stile del sito a partire da un nome di dominio.
Come funziona Context.dev
Ottieni una chiave API
Registrati, verifica l’email e copia la chiave dalla dashboard, oppure fai fare la configurazione a un agente di programmazione con un’istruzione di una riga.
Scegli che cosa recuperare
Decidi se fare lo scraping di un URL, mappare un dominio o fare il crawling di un intero sito; tutti usano la stessa chiave.
Integra
Installa un SDK e chiama l’API dal tuo flusso di lavoro seguendo la documentazione e il codice di esempio.
Pubblica
Usa i dati restituiti per alimentare agenti, pipeline di recupero, ricerche o funzioni di automazione.
Screenshot
Casi d’uso
- Alimentare un indice RAG
- Raccogli le pagine di documentazione in Markdown e aggiorna quelle che cambiano.
- Costruire un chatbot per un sito
- Fai il crawling dell’intero sito di un cliente per creare la base di conoscenza di un bot di assistenza.
- Monitoraggio dei prezzi
- Controlla le pagine dei prezzi dei concorrenti e ricevi un webhook quando le cifre cambiano.
- Compilazione automatica durante l’onboarding
- Recupera il profilo aziendale e i colori del brand di un nuovo utente dal suo dominio per precompilare la configurazione.
- Compiti di ricerca per agenti
- Dai a un agente risposte con fonti a domande fattuali, invece dei risultati grezzi di una ricerca.
Cose da sapere
- I crediti variano a seconda dell’endpoint
- Uno scraping di base costa 1 credito, ma l’estrazione JSON, le risposte, il recupero dei dati del brand e l’arricchimento dei dati di una persona ne consumano di più.
- Che cosa succede a zero crediti
- I piani a pagamento possono ricaricarsi automaticamente a blocchi da 1.000 crediti; senza crediti né ricarica, le richieste restituiscono un errore di utilizzo superato.
- Limiti di concorrenza
- Il numero di richieste simultanee è limitato per piano, da una nel livello gratuito a 500 in Scale.
- Sconto per startup e organizzazioni non profit
- Le organizzazioni idonee possono richiedere una riduzione del 30% su un piano annuale a pagamento, valida per dodici mesi.
Domande frequenti
Che cos’è Context.dev?
Context.dev è un’API di web scraping per agenti di IA e pipeline di LLM che fa scraping, crawling, ricerca e monitoraggio di pagine web tramite un’unica interfaccia REST.
Context.dev è gratis?
Sì, c’è un livello gratuito. Context.dev dà 1.000 crediti API al mese senza chiedere una carta di credito, e bastano per 1.000 scraping standard.
Quanto costa Context.dev?
Context.dev: è disponibile un piano gratuito. Le tariffe dei piani a pagamento sono pubblicate su context.dev. Consulta la pagina ufficiale dei prezzi per gli importi aggiornati.
Come funzionano i crediti di Context.dev?
Uno scraping standard di Context.dev usa 1 credito. Le azioni nel browser, l’estrazione JSON, le risposte e le ricerche sul brand costano di più, per esempio 5 crediti per una pagina con estrazione JSON.
Context.dev applica costi extra per il rendering JavaScript o i proxy?
No. Context.dev include rendering, gestione dei sistemi anti-bot e proxy nel prezzo base dello scraping.
Quali SDK fornisce Context.dev?
Context.dev pubblica SDK ufficiali per Python, TypeScript, Go, Ruby e PHP.
Mi vengono addebitate le richieste fallite di Context.dev?
Per lo più no. Context.dev dice che la maggior parte delle richieste fallite è gratuita, mentre le risposte 404 vengono addebitate al prezzo base della richiesta.
Context.dev può fare il crawling di un intero sito web?
Sì. Una chiamata di crawling gestisce fino a 500 pagine, e Context.dev consiglia i batch in modalità crawl per i siti più grandi.
A chi è rivolto
- Ingegneri dell’IA
- Sviluppatori di agenti
- Team RAG
- Team di prodotto SaaS
- Data engineer
Commenti
Ancora nessun commento. Se hai usato Context.dev, racconta agli altri lettori com’è andata.
Alternative a Context.dev
| Strumento | Piano gratuito | Prezzo di partenza | API |
|---|---|---|---|
 FirecrawlAPI di dati dal web che cerca, estrae, esplora e interagisce con i siti e restituisce risultati puliti per le applicazioni di IA. |
Sì | 16 $/mese | Sì |
 CrawlbaseInfrastruttura di crawling e scraping del web con un’API di crawling, proxy a rotazione, scraper gestiti e un server MCP. |
Sì | — | Sì |
 Axiom.aiStrumento di automazione del browser e web scraping con un’estensione per Chrome senza codice, API per sviluppatori e un server MCP. |
— | — | Sì |
 ScrapelessInfrastruttura di dati web e browser nel cloud per gli agenti di IA: browser per agenti, scraper di IA, web unlocker, crawl e proxy. |
— | — | Sì |
 TinyFishInfrastruttura web per agenti di IA: API di ricerca, fetch, browser nel cloud e agente web autonomo con un’unica chiave. |
Sì | — | Sì |
Strumenti delle stesse categorie di Context.dev. Il prezzo di partenza compare solo se lo abbiamo controllato sulla pagina dei prezzi dello sviluppatore; un trattino significa che non è stato controllato o non è pubblicato. Tutti gli strumenti della categoria Web scraping ed estrazione di dati